HubSpotの年次カンファレンス「UNBOUND 2026」のセッション「From Data Strategy to AI Execution」をレポートします。前半ではセッションの内容を整理し、後半では株式会社100の解説として、日本でHubSpotを使う企業がどう実務に取り入れるべきかをまとめます。
この記事のポイント
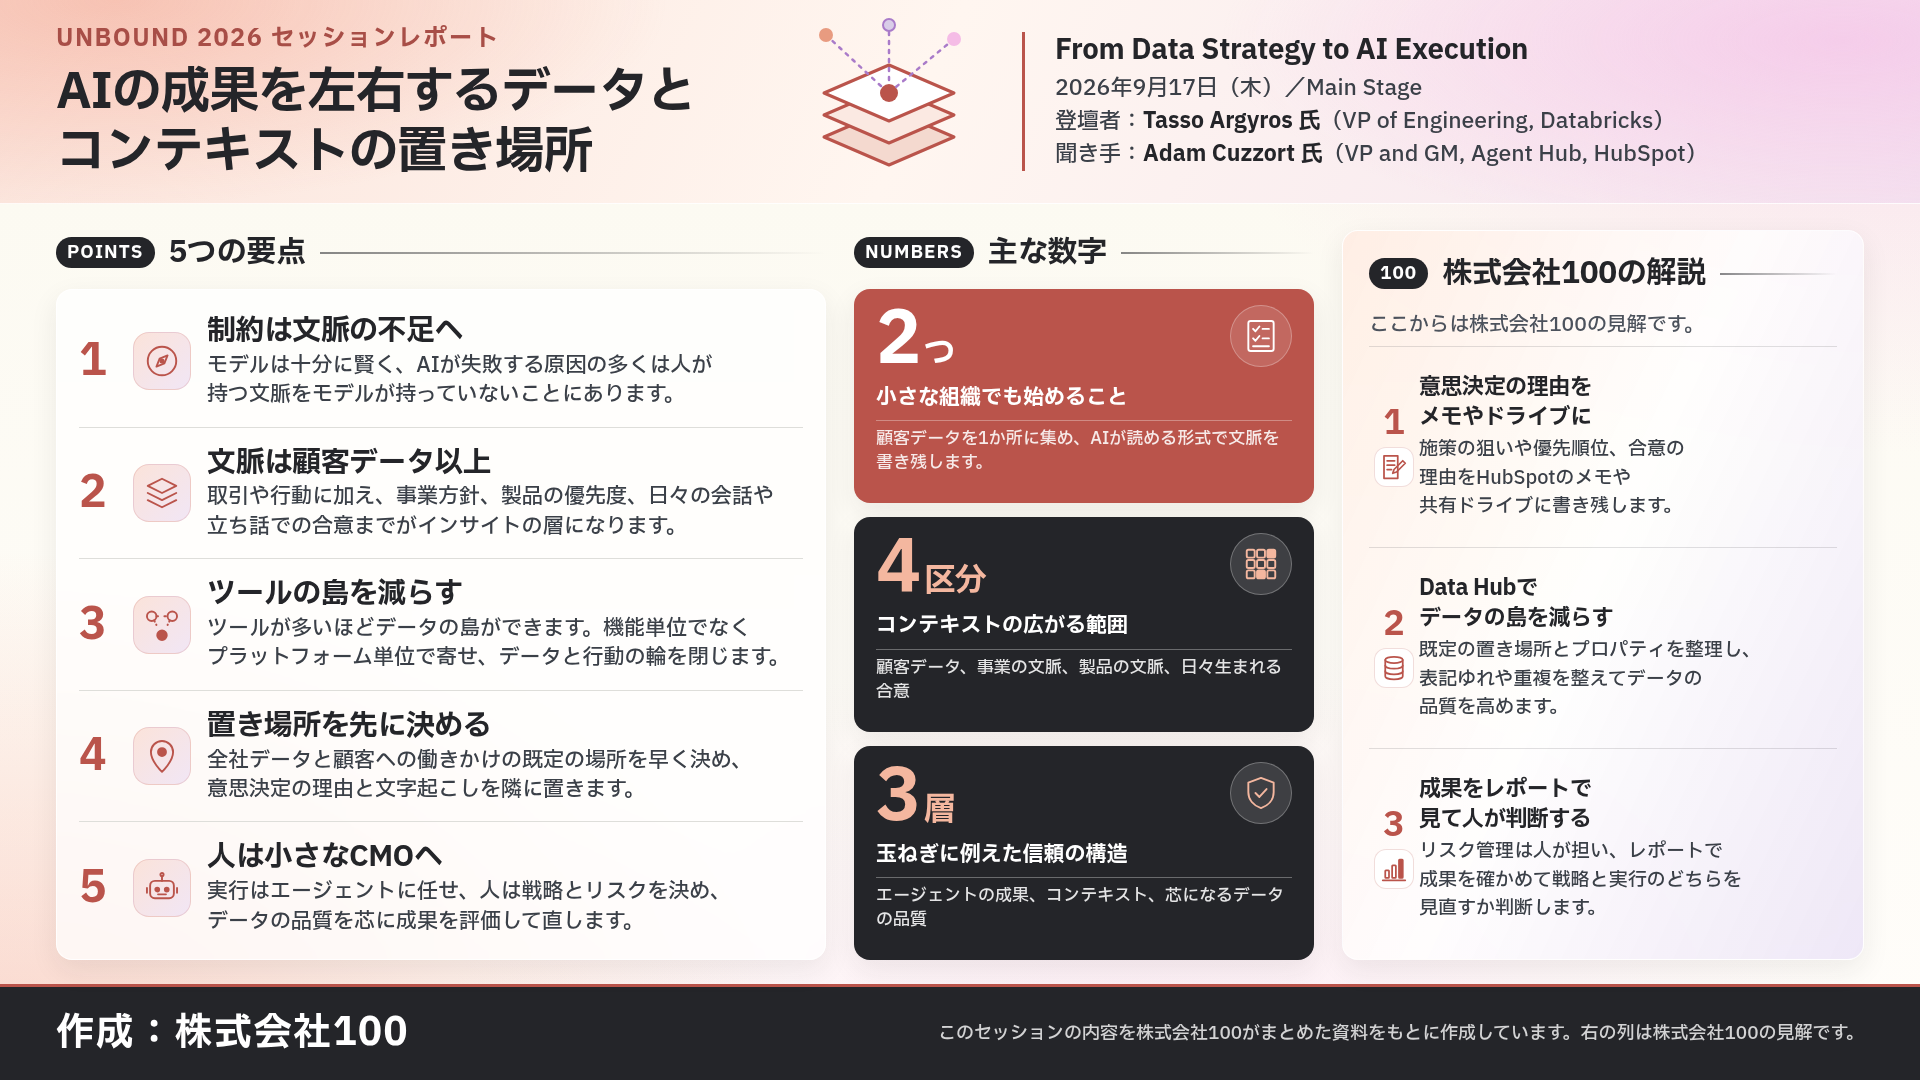
- AIの成果を妨げる最大の要因は、AIモデルの知性ではなく、「分断されたデータ」と「書き残されていないコンテキスト(文脈)」にあります。
- ツールごとにデータの島(サイロ)ができるのを防ぐためデータを1か所に集約し、人間は作業の実行者から「戦略と評価を担う役割」へとシフトします。
- 日本企業が取り入れる際は、日々の意思決定の理由や背景をテキストで記録し、HubSpotで顧客データを整えるところから始めるのが効果的です。
出典:株式会社100作成のセッションまとめ資料
セッション情報
| 項目 | 内容 |
|---|---|
| セッション名 | From Data Strategy to AI Execution |
| 会場 | Main Stage |
| 開催日 | 2026年9月17日(木) |
| 登壇者 | Tasso Argyros 氏(VP of Engineering, Databricks) |
| 聞き手 | Adam Cuzzort 氏(VP and GM, Agent Hub, HubSpot) |
| 動画 | From Data Strategy to AI Execution | UNBOUND 2026 | HubSpot Live(YouTube) |
※「株式会社100の解説」より前のパートは、セッションの講演内容とスライドを株式会社100が要約・整理したものです。
セッションの内容は、株式会社100がまとめた資料(PDF)でもご覧いただけます。まとめ資料を開く(PDF)
AIの成果を止めているものは何か?
AIモデルの知性そのものよりも、「人間が頭の中に持っているコンテキスト(文脈)の不足」が事業の成果を妨げています。
本セッションは、DatabricksのTasso Argyros氏とHubSpotのAdam Cuzzort氏の2人による対談形式で進みました。Argyros氏はエンタープライズ向けCDPのActionIQなどを創業し、現在はDatabricksで「Customer Lake」を率いています。一方のCuzzort氏はHubSpotでデータ基盤チームを統括し、統合データを「Agentic Customer Platform」へつなぐ土台づくりを担っています。
Argyros氏は、現在のAIモデルはすでに多くの領域で人間の業務の大半をこなせるほど賢いとし、「AI活用が失敗する原因の多くは、人間が持っている文脈(コンテキスト)をAIモデルが持っていないことにある」と指摘しました。AIにおける制約は「モデルの知性」から「コンテキストの不足」へと移っており、これが今も事業の成果を妨げるボトルネックになっています。
小規模な組織であっても対応が早すぎるということはありません。AIの働きを弱めてしまうのは、分断されたデータと、どこにも書き残されていない文脈です。同氏は今すぐ始めるべき2つのアクションとして、「①顧客のデータを1か所に集めること」「②AIが読み取れる場所と形式で文脈を書き残すこと」を挙げ、「どのAIモデルを使うかという議論は、データとコンテキストが整っているかどうかに比べれば些細な問題だ」と強調しました。
コンテキストとは何を指すのか?
コンテキストとは、顧客の行動データだけでなく、事業や製品の優先順位、社内の日々の合意までを含む幅広い情報を指します。
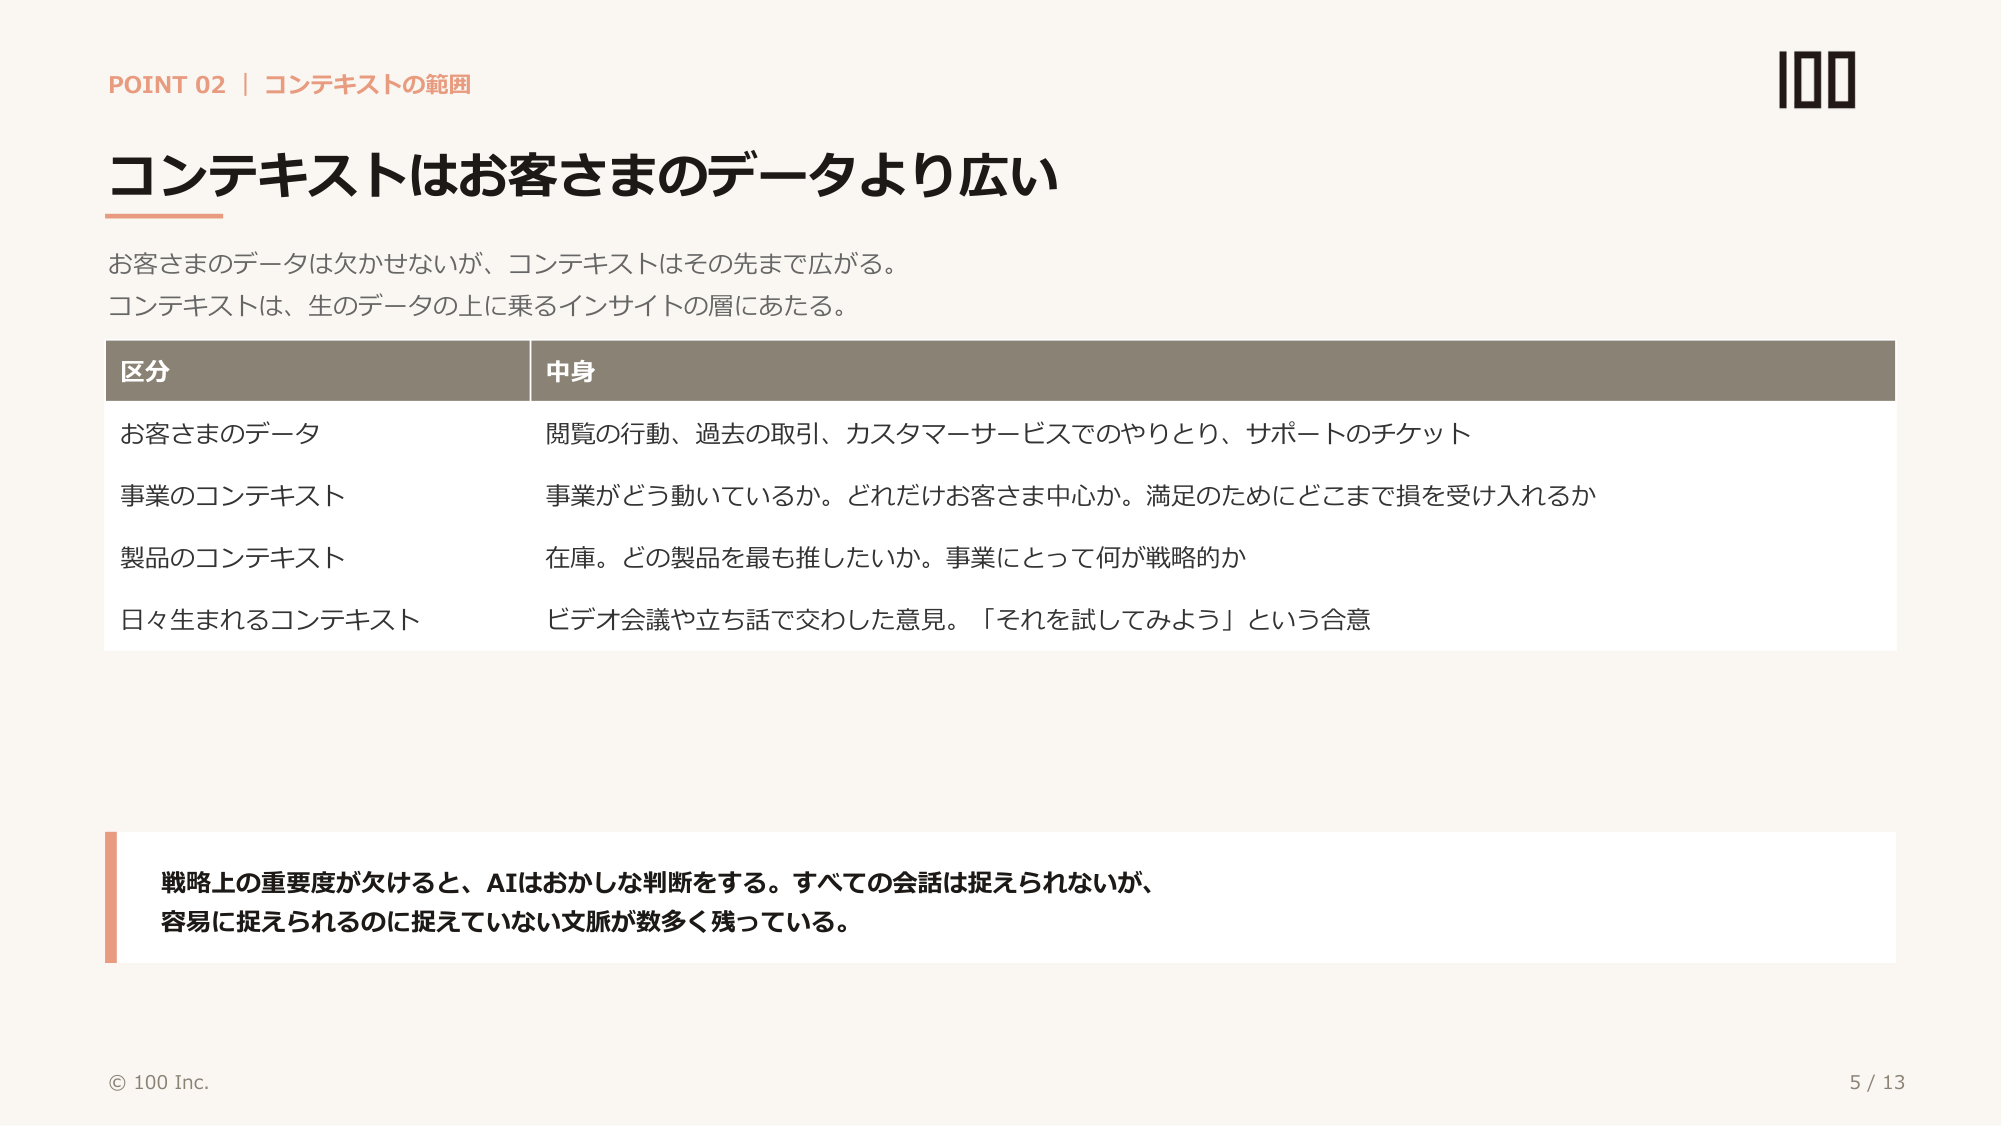
Cuzzort氏は、コンテキストを「生のデータの上に乗るインサイト(洞察)の層」と位置づけました。さらにArgyros氏は、コンテキストは顧客データの枠を超えて大きく広がるとし、顧客データとあわせて次の4つに整理しました。
- 顧客のデータ:Webサイトの閲覧行動、過去の取引履歴、カスタマーサービスのやり取り、サポートのチケット履歴など。
- 事業のコンテキスト:ビジネスの構造、顧客中心主義の度合い、顧客満足のためにどこまでコストや譲歩を受け入れるかといった判断基準。
- 製品のコンテキスト:現在の在庫状況、いま最も売り出したい注力製品、事業にとって何が戦略的に重要かという優先順位。
- 日々生まれるコンテキスト:オンライン会議や立ち話で出た意見、「次はこれを試してみよう」といった日々の合意事項。
出典:株式会社100作成のセッションまとめ資料
こうした戦略上の優先順位や背景が欠けていると、AIは的外れな判断を下してしまいます。本来なら簡単に記録できるはずなのに書き残されていない文脈が数多くあり、それが自律的に動くAI(エージェント)の成果を下げています。
ツールが多いと、なぜエージェントは成果を出しにくいのか?
ツールが増えるほど「データの小さな島」が生まれ、AIエージェントが全体の文脈をつかみにくくなるためです。
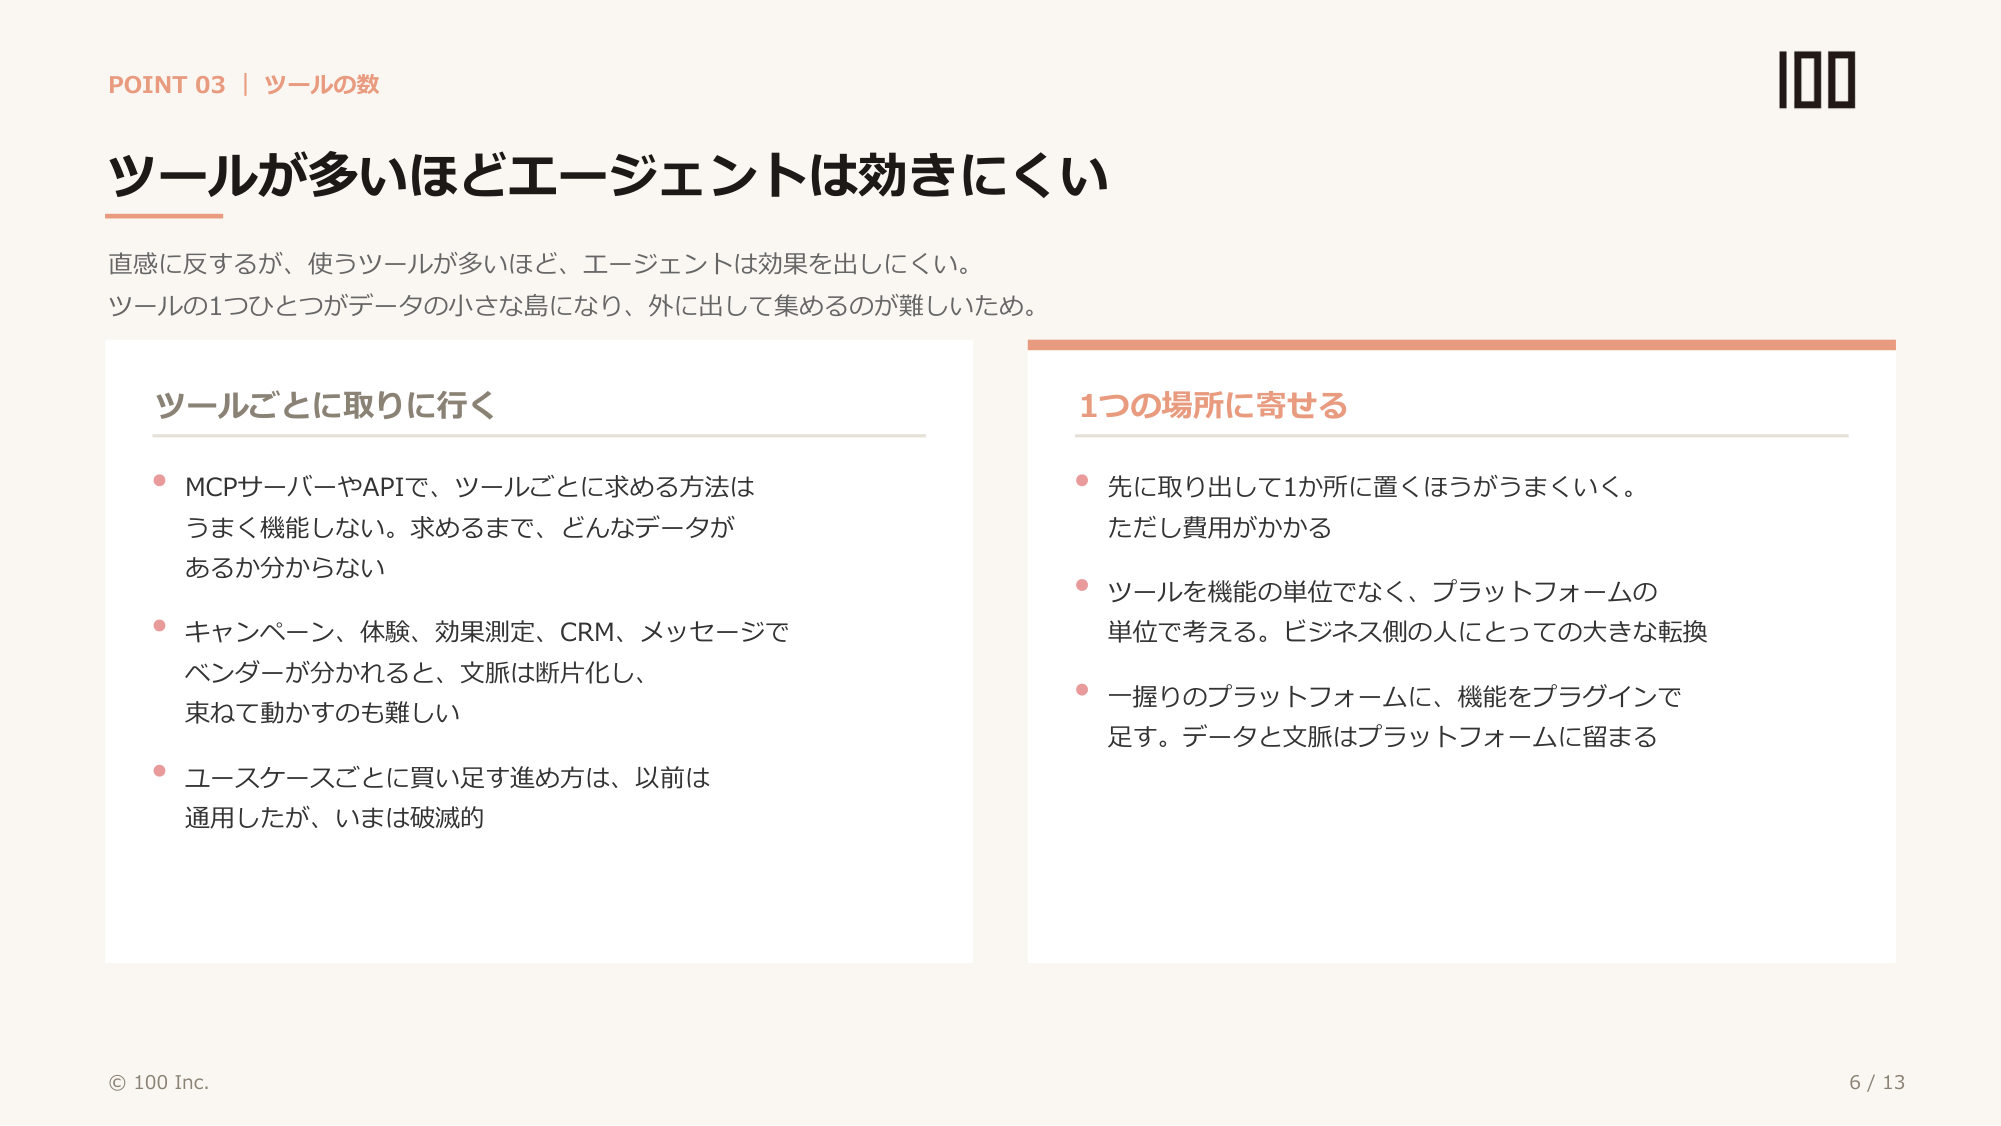
Argyros氏は、社内で使うツールが多いほどデータが島のように孤立(サイロ化)し、1つに集めるのが難しくなると指摘しました。
AIエージェントが社内のデータと文脈にアクセスする方法は大きく2つあります。1つ目は、MCPサーバーやAPIを通じて必要になるたび各ツールへデータを取りに行く方法ですが、これは「取りに行くまでそこにどんなデータがあるか分からない」ため、実際にはうまく機能しません。2つ目は、あらかじめデータを取り出して1か所に集めておく方法で、こちらは確実に機能するものの、多数のツールが乱立していると統合に高いコストがかかります。
キャンペーン管理、顧客体験、効果測定、CRM、メッセージ配信でそれぞれ別々のツールを使っていると文脈が断片化するため、「用途(ユースケース)ごとに個別ツールを買い足す進め方」はAI時代において大きな足かせになります。そのため今後は、ツールを単一機能の単位ではなく「プラットフォームの単位」で捉え、少数の基幹プラットフォームの上に機能をプラグインとして追加し、データと文脈は常にそのプラットフォーム内に留める形へ移行していくという見通しが示されました。
出典:株式会社100作成のセッションまとめ資料
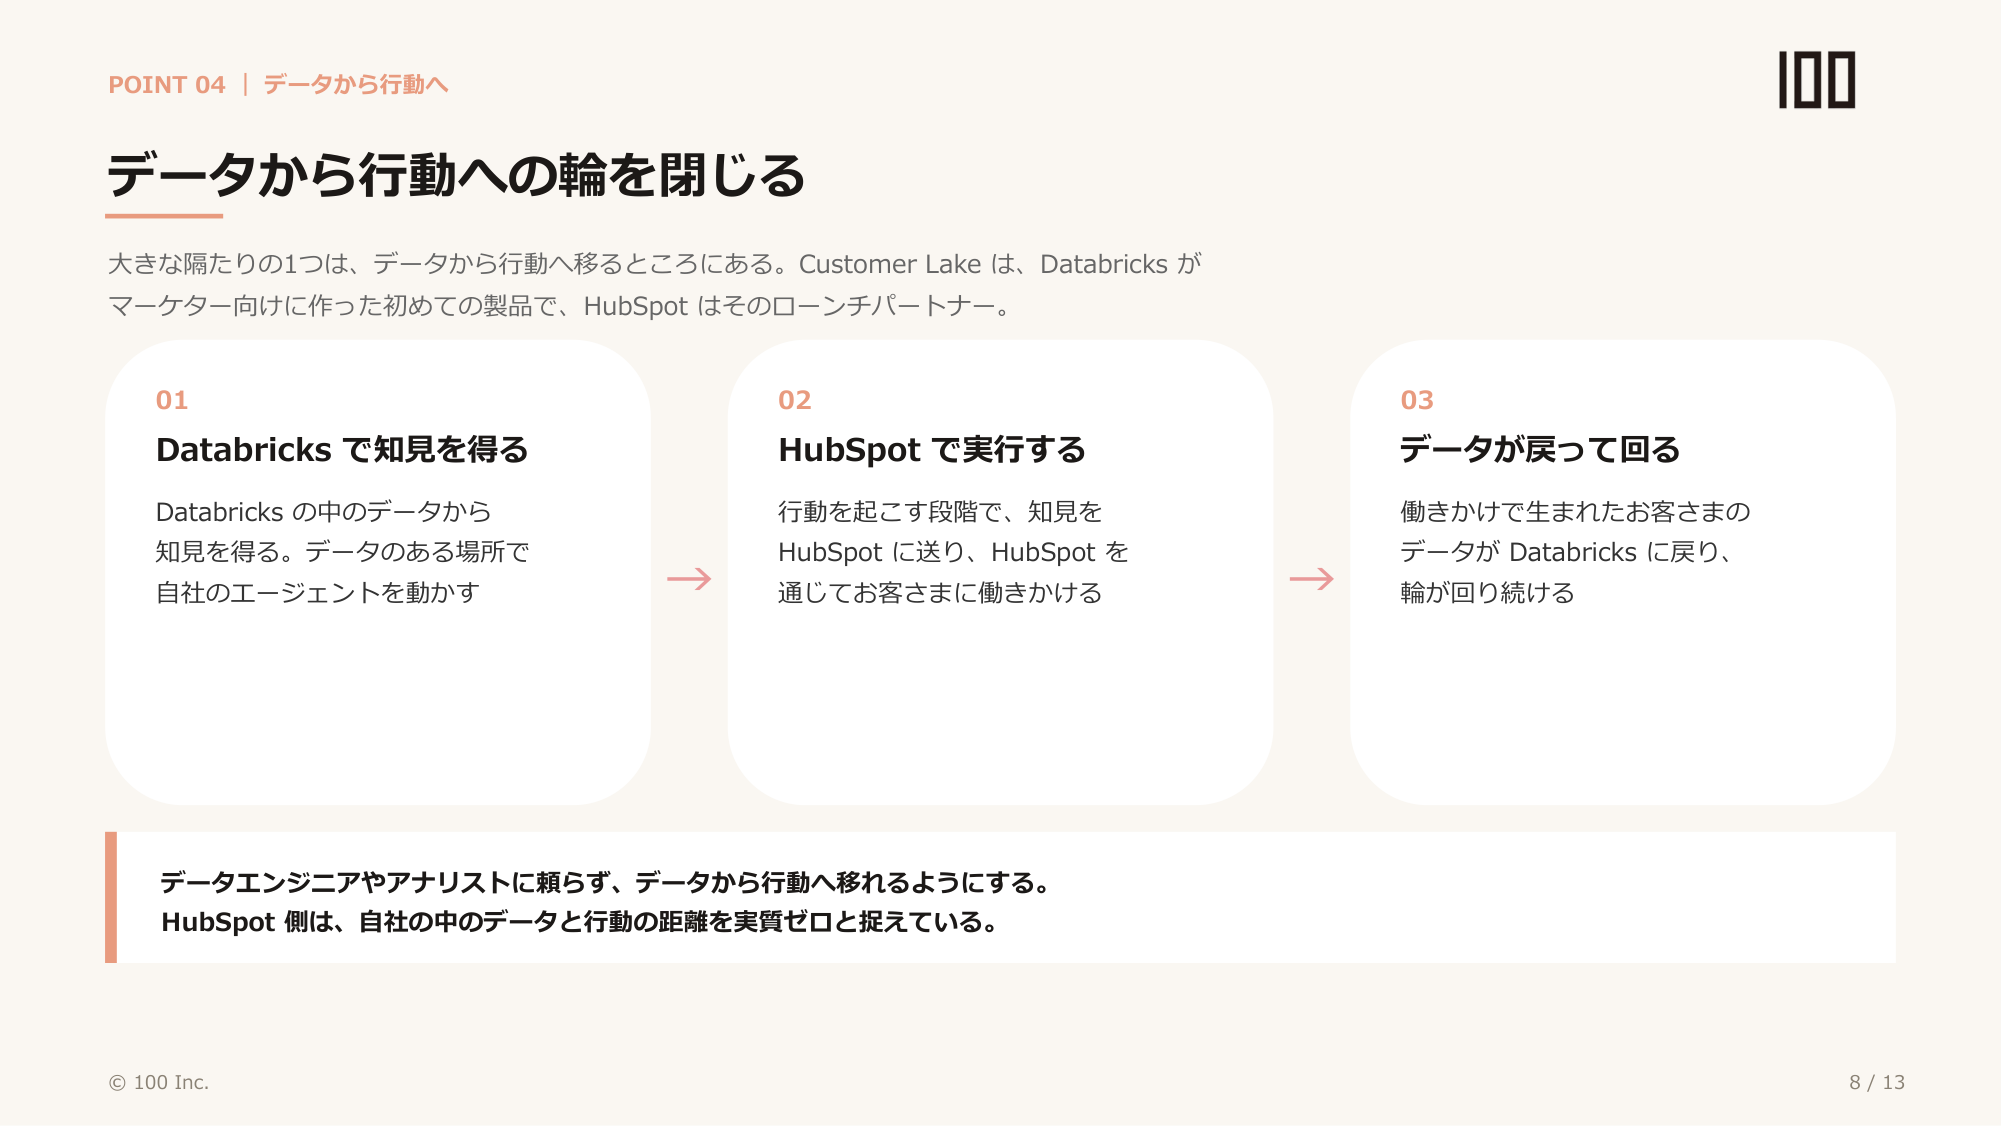
また、「データの蓄積」から「実際のアクション」へ移るまでの隔たりを埋める製品として、Databricksがマーケター向けに初めて開発した「Customer Lake」(HubSpotがローンチパートナー)が紹介されました。データエンジニアやアナリストの手を借りることなく、次の3つのステップでデータと行動のサイクルをつなぎます。
- Databricks内のデータから知見(インサイト)を得て、自社のAIエージェントを動かす。
- 得た知見をHubSpotへ送り、顧客へアプローチする。
- アプローチによって生まれた顧客の反応データが再びDatabricksへ戻り、サイクルが回り続ける。
Cuzzort氏も、HubSpot内の「データ」と「行動」の距離を実質ゼロに近づけていると語りました。
出典:株式会社100作成のセッションまとめ資料
データと文脈の置き場所はどう決めるのか?
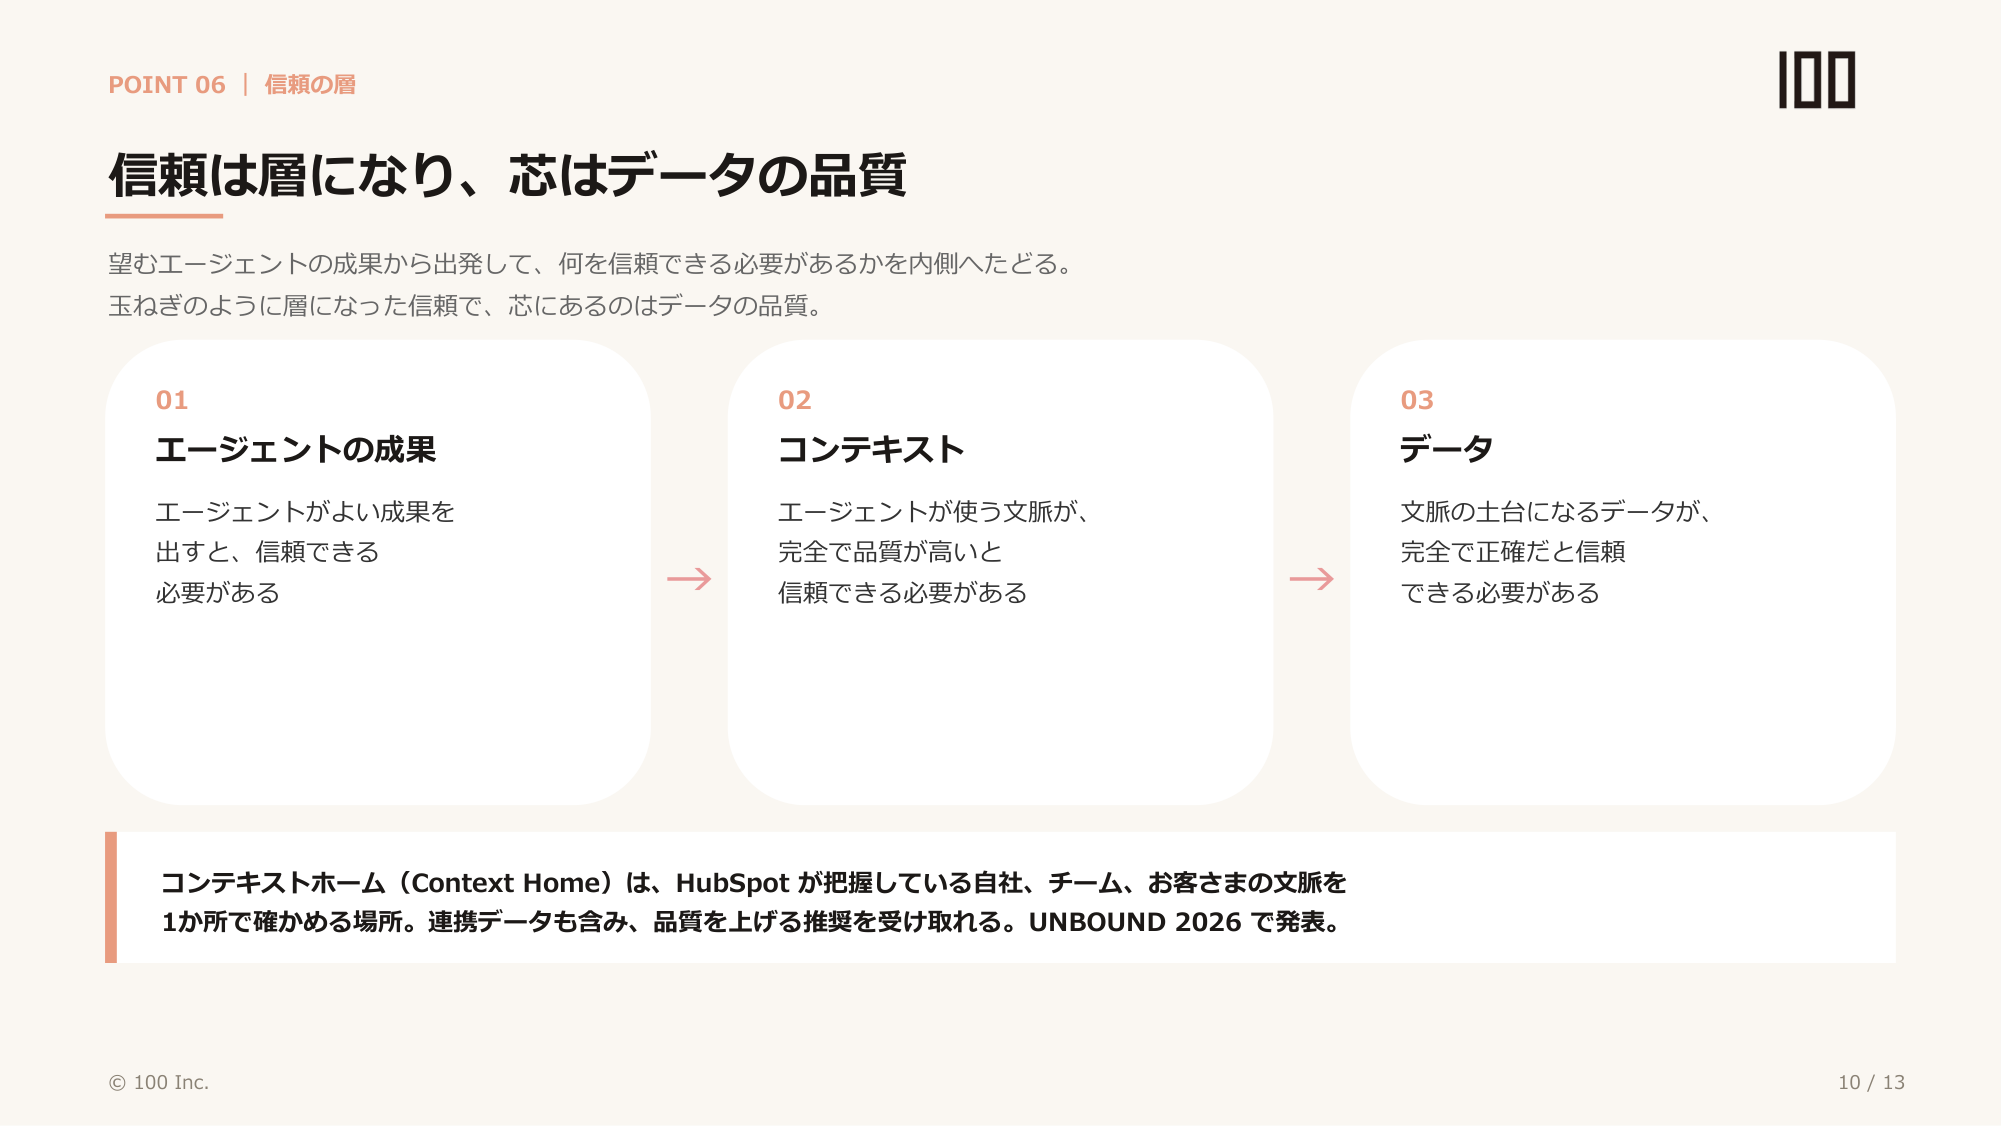
全社データの「既定の置き場所」を早い段階で定め、データ品質を芯に据えた「信頼の層」を整えるアプローチが示されました。
Argyros氏は、ツールが増え切ってから過去にさかのぼって統合するよりも、新しいツールを導入する段階で置き場所を寄せていくほうが圧倒的に容易だと述べました。全社データの基本となるプラットフォームを決め、顧客に関わる仕組みはHubSpotのような1つの場所に集約します。一方で、事業全体のコンテキストはDatabricksやGoogle ドライブ、Microsoftのストレージなどに集約し、意思決定の理由や社内会議の文字起こしを、いつでも顧客データと照らし合わせられる「隣り合った場所」に置きます。
Cuzzort氏は、AIのアウトプットから内側へとたどる「信頼の3層構造」を玉ねぎに例えて解説しました。AIエージェントの成果(一番外側)を信頼するためには、その内側に「完全で高品質なコンテキスト」が必要であり、さらにその中心の芯には「完全で正確なデータの品質」が欠かせません。
あわせて、UNBOUND 2026で発表された新機能「Context Home」が紹介されました。これは自社やチーム、顧客に関するコンテキストを外部連携データも含めて1か所で確認でき、データ品質を高めるための改善提案を受け取れる機能です。
出典:株式会社100作成のセッションまとめ資料
AIの時代に人の役割はどう変わるのか?
人間は「作業を実行する立場」から、1人ひとりが小さなCMOのように「戦略とリスクを決めてエージェントを導き、成果を評価する立場」へと変わります。
Argyros氏は、「AIエージェントだけで回る会社はあり得ない」と断言し、これからの専門職は「実行する人」から「導き、管理する人」へ移ると語りました。「導く」とは、自分自身の見解を持ち、戦略や優先順位、投資先、そしてどこまでリスクを取るかを決めることです。企業のブランドと予算がかかる以上、リスク管理をAIに丸投げすることはできません。誰もが「小さなCMO(最高マーケティング責任者)」のような視座を持ち、AIが出した成果を見て「戦略の問題なのか、実行の問題なのか」を切り分けて軌道修正する役割へと移ります。
Cuzzort氏はHubSpotの製品方針として、エージェント作成ツール(Agent Builder)などの新機能には、「エージェントがどう動き、どのデータやコンテキストを使って判断したか」を人間が透明性をもって確認できる仕組みを組み込んでいると説明しました。
セッションの終盤、Argyros氏は数学の世界を例に挙げました。「AIモデルが数学の定理を証明し始めたことで、数学者たちの間では『数学の本質とは定理を証明する作業ではなく、その証明が何を意味するのかを理解することだったのだ』という見方が広がっている」と紹介し、ビジネスの世界でも「結果の意味を理解して導く役割」が人間に残ることを強調しました。
株式会社100の解説:HubSpotでどう実践するか?
ここからは、日本のB2B企業を支援する株式会社100の見解です。
1. 意思決定の理由と背景をHubSpotのメモや共有ドライブに残す
日本の企業では、会議での合意事項や「なぜこの施策を選んだのか」という背景が、担当者の頭の中や口頭のやり取りだけに留まり、文書として残らないケースが少なくありません。BreezeアシスタントなどのAI機能を実務で生かす土台として、施策の狙いや優先順位、意思決定の理由、商談通話の記録などをHubSpotのメモ機能や連携ドライブにテキストで書き残す習慣をつけることをおすすめします。
2. Data Hubとプロパティの整理で「データの島」を減らす
部門や施策ごとに個別ツールを買い足した結果、顧客データが分散し、表記ゆれや重複が生じているケースは多くの日本企業で見られます。「信頼の芯」となるデータの品質を高めるには、顧客データの既定の置き場所をHubSpotに定め、Data Hubを活用してデータ形式を整えるとともに、「どのプロパティに何の情報を持たせるか」のルールを全社で統一するアプローチが有効です。
3. ワークフローとエージェントの役割を分け、成果をレポートで確かめる
稟議プロセスやブランド保護が重視される日本企業において、リスク管理までを含めてAIにすべて任せるのは現実的ではありません。ルールが決まっている定型手順は「ワークフロー」で確実に自動化し、AIエージェントの実行内容は人間がプロセスを確認できるようにしたうえで、最終的な成果をレポートとダッシュボードで検証し、「戦略と実行のどちらを見直すか」を人が判断する体制をつくるのが理想的です。
よくある質問(FAQ)
Q1. 小規模な組織でも、データと文脈の置き場所を整える必要がありますか?
はい、組織が小さいうちから取り組むほど後から統合する手間がかかりません。まずは顧客データをHubSpotのような1つの場所に集約し、日々の意思決定の理由や顧客とのやり取りをAIが読み取れるテキスト形式でメモに残すところから始めるのがおすすめです。
Q2. なぜ多くのツールを併用するとAIエージェントの効果が下がるのですか?
ツールごとに「データの小さな島」ができ、全体の文脈が断片化してしまうためです。MCPサーバーやAPIでその都度データを取りに行く方法では、どこにどんなデータがあるかをAIが事前に把握しきれません。顧客データの置き場所を1つのプラットフォームに寄せ、分断を減らす設計が重要です。
Q3. 顧客の行動データ以外に、どんなコンテキスト(文脈)を記録すべきですか?
セッションでは、事業の方針、在庫状況や注力製品の優先順位、社内の日々の合意、意思決定の理由、社内会議や通話の文字起こしが挙げられました。実務においては、「なぜその判断を下したのか」という基準や背景をテキストで残しておく工夫がAIの精度向上に役立ちます。
Q4. AIエージェントが普及すると、マーケティングや営業担当者の仕事はどう変わりますか?
手を動かして作業を実行する役割から、1人ひとりが「小さなCMO」のように戦略や優先順位・リスクを決め、AIが出した成果を見て「戦略と実行のどちらに課題があるか」を切り分けて改善する役割へと変わります。HubSpotのレポート機能で成果を客観的に確かめながら、人間が意思決定を下す体制づくりが求められます。
まとめ
「From Data Strategy to AI Execution」は、AIの成果を妨げている最大の要因が「コンテキスト(文脈)の不足」にあることを明らかにし、データと文脈を1か所に集約したうえで、人間は「戦略と評価」を担う役割へと進化すべきだと示したセッションでした。
まずは自社の顧客データを1か所に整えること、そして日々の意思決定の理由をテキストで残すことから始めてみてはいかがでしょうか。株式会社100では、Data Hubを用いたデータ基盤の整備や、AI活用を見据えたHubSpotの運用設計を支援しています。ぜひお気軽にご相談ください。
中野太夢
2016年にSNSマーケティング支援会社へ新卒入社し、大手グローバル企業のSNSアカウント運用支援およびチームリーダーを担当。2020年にCRM/MA導入コンサルティング会社へ転籍し、Salesforce・Account Engagement(旧Pardot)を用いたBtoB企業の活用支援に従事。その後、飲食店舗の店長として現場運営に携わり、売上・原価・集客の改善に取り組んだ。現在は株式会社100 ソリューション事業部BizDevとして海外SaaSの日本展開を担い、日本語の営業資料・Webサイトの整備、問い合わせ獲得、社内メンバーへの提案浸透までを一気通貫で進めている。趣味はサッカー、カメラ、料理、キャンプ。
この記事をシェアする


https://hubspot.100inc.co.jp/unbound-2026-data-strategy-ai-execution
コピーWe are HubSpot LOVERS
ビジネスの成長プラットフォームとしての魅力はもちろん、
HubSpotのインバウンドマーケティングという考え方、
顧客に対する心の寄せ方、ゆるぎなく、そしてやわらかい哲学。
そのすべてに惹かれて、HubSpotのパートナー、
エキスパートとして取り組んでいます。
HubSpotのこと、マーケティング設計・運用、
組織の構築など、どんなことでもお問い合わせください。