HubSpotの年次カンファレンス「UNBOUND 2026」で行われたセッション「From Prompt to Product: Build an AI Agent」のレポートをお届けします。前半ではセッションの要点を整理し、後半では株式会社100の解説として、日本のHubSpotユーザー企業がこれらの知見をどう実務に取り入れるべきかをまとめます。
この記事のポイント
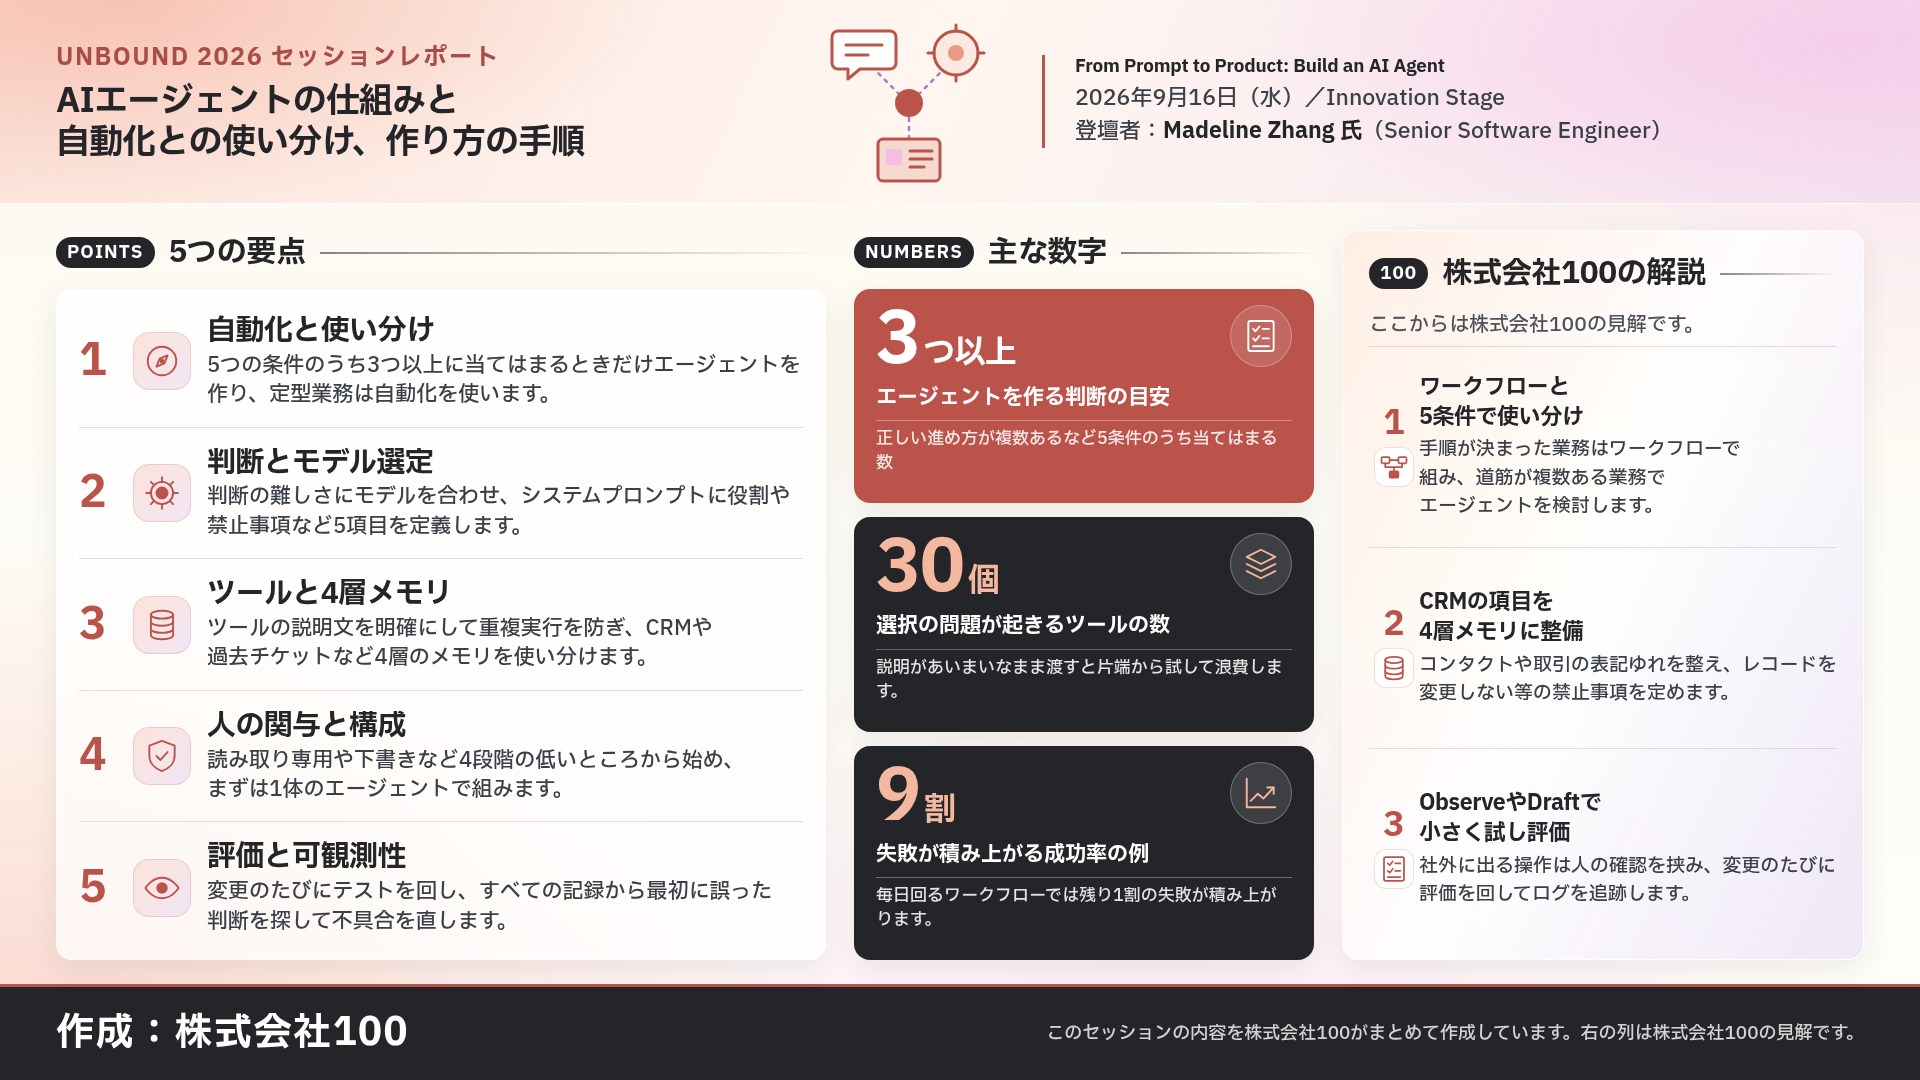
- 自動化との使い分け: 手順が毎回同じ業務には「従来の自動化」を選び、道筋が複数あるなど「5つの条件」のうち3つ以上に当てはまる場合のみ「AIエージェント」を構築します。
- 構築と運用の手順: システムプロンプト、ツール、4層のメモリ、人の関与(Human-in-the-loop)、評価と可観測性を順に設計し、「読み取り専用」から小さくテストを始めます。
- HubSpotでの実践(株式会社100の見解): 定型業務は「ワークフロー」に任せ、AIの記憶領域となるCRMデータを整えたうえで、人の確認を挟みながら段階的にAIエージェントを導入するアプローチが有効です。
出典:株式会社100作成のセッションまとめ資料
セッション情報
| 項目 | 内容 |
|---|---|
| セッション名 | From Prompt to Product: Build an AI Agent |
| 会場 | Innovation Stage |
| 開催日 | 2026-09-16 |
| 登壇者 | Madeline Zhang 氏(Senior Software Engineer, HubSpot) |
※本記事のセッション内容は株式会社100が要約したものであり、後半の「株式会社100の解説」は当社の独自見解です。
セッションの全体像は、以下のまとめ資料(PDF)でもご覧いただけます。 まとめ資料を開く(PDF)
AIエージェントを作るべきか、どう判断するのか?
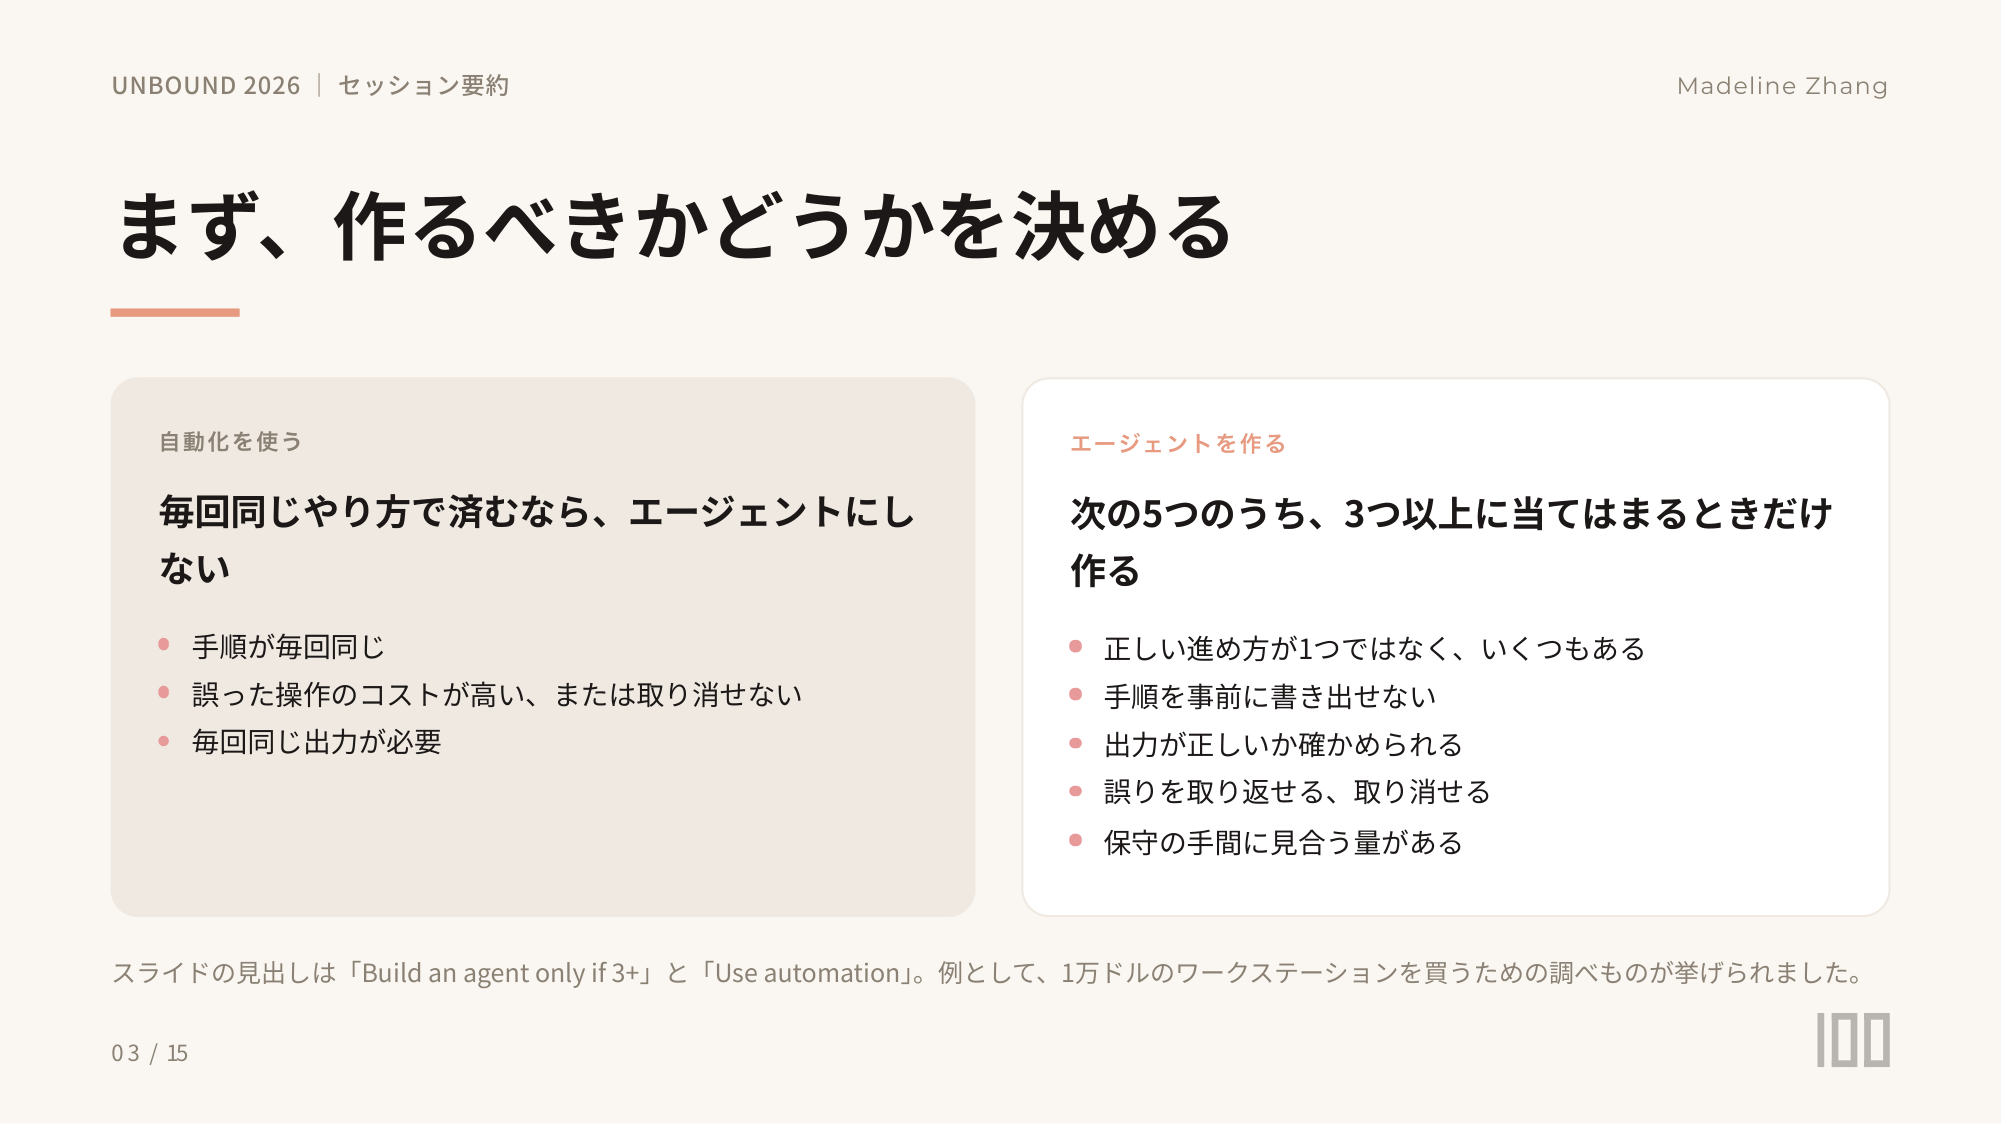
毎回同じ手順で済むなら「自動化」を使い、5つの条件のうち3つ以上に当てはまるときだけ「AIエージェント」を作ります。
登壇者のMadeline Zhang氏は、「手順が毎回同じ」「ミスの代償が大きく取り消せない」「毎回同じ出力が求められる」といった業務には、従来の自動化(ルールベースの仕組み)を使うべきだと述べました。
一方で、自律して動くAIエージェントを作るべきなのは、次の5条件のうち3つ以上に当てはまる場合のみです(例として、1万ドルのワークステーションを購入する際の複雑な事前調査などが挙げられました)。
- ゴールに至る正しい進め方がいくつもある
- 手順を事前にすべて書き出せない
- 出力結果が正しいか後から検証できる
- 万が一誤りがあっても取り返せる(取り消せる)
- 構築・保守の手間に見合うだけの業務量がある
出典:株式会社100作成のセッションまとめ資料
AIエージェントのループ処理において、AIモデルは「次に何をするか」を判断するだけであり、実際に動かすのはプログラム(コード)側です。「判断する → ツールを呼ぶ → 結果を見る → また判断する」というサイクルを繰り返します。目標達成の条件だけでは無限ループに陥り止まらないケースがあるため、「最大ステップ数」を設定し、上限に達したら人間へ引き継ぐ逃げ道(エスカレーション)を必ず用意します。
モデルとシステムプロンプト、ツールはどう設計するのか?
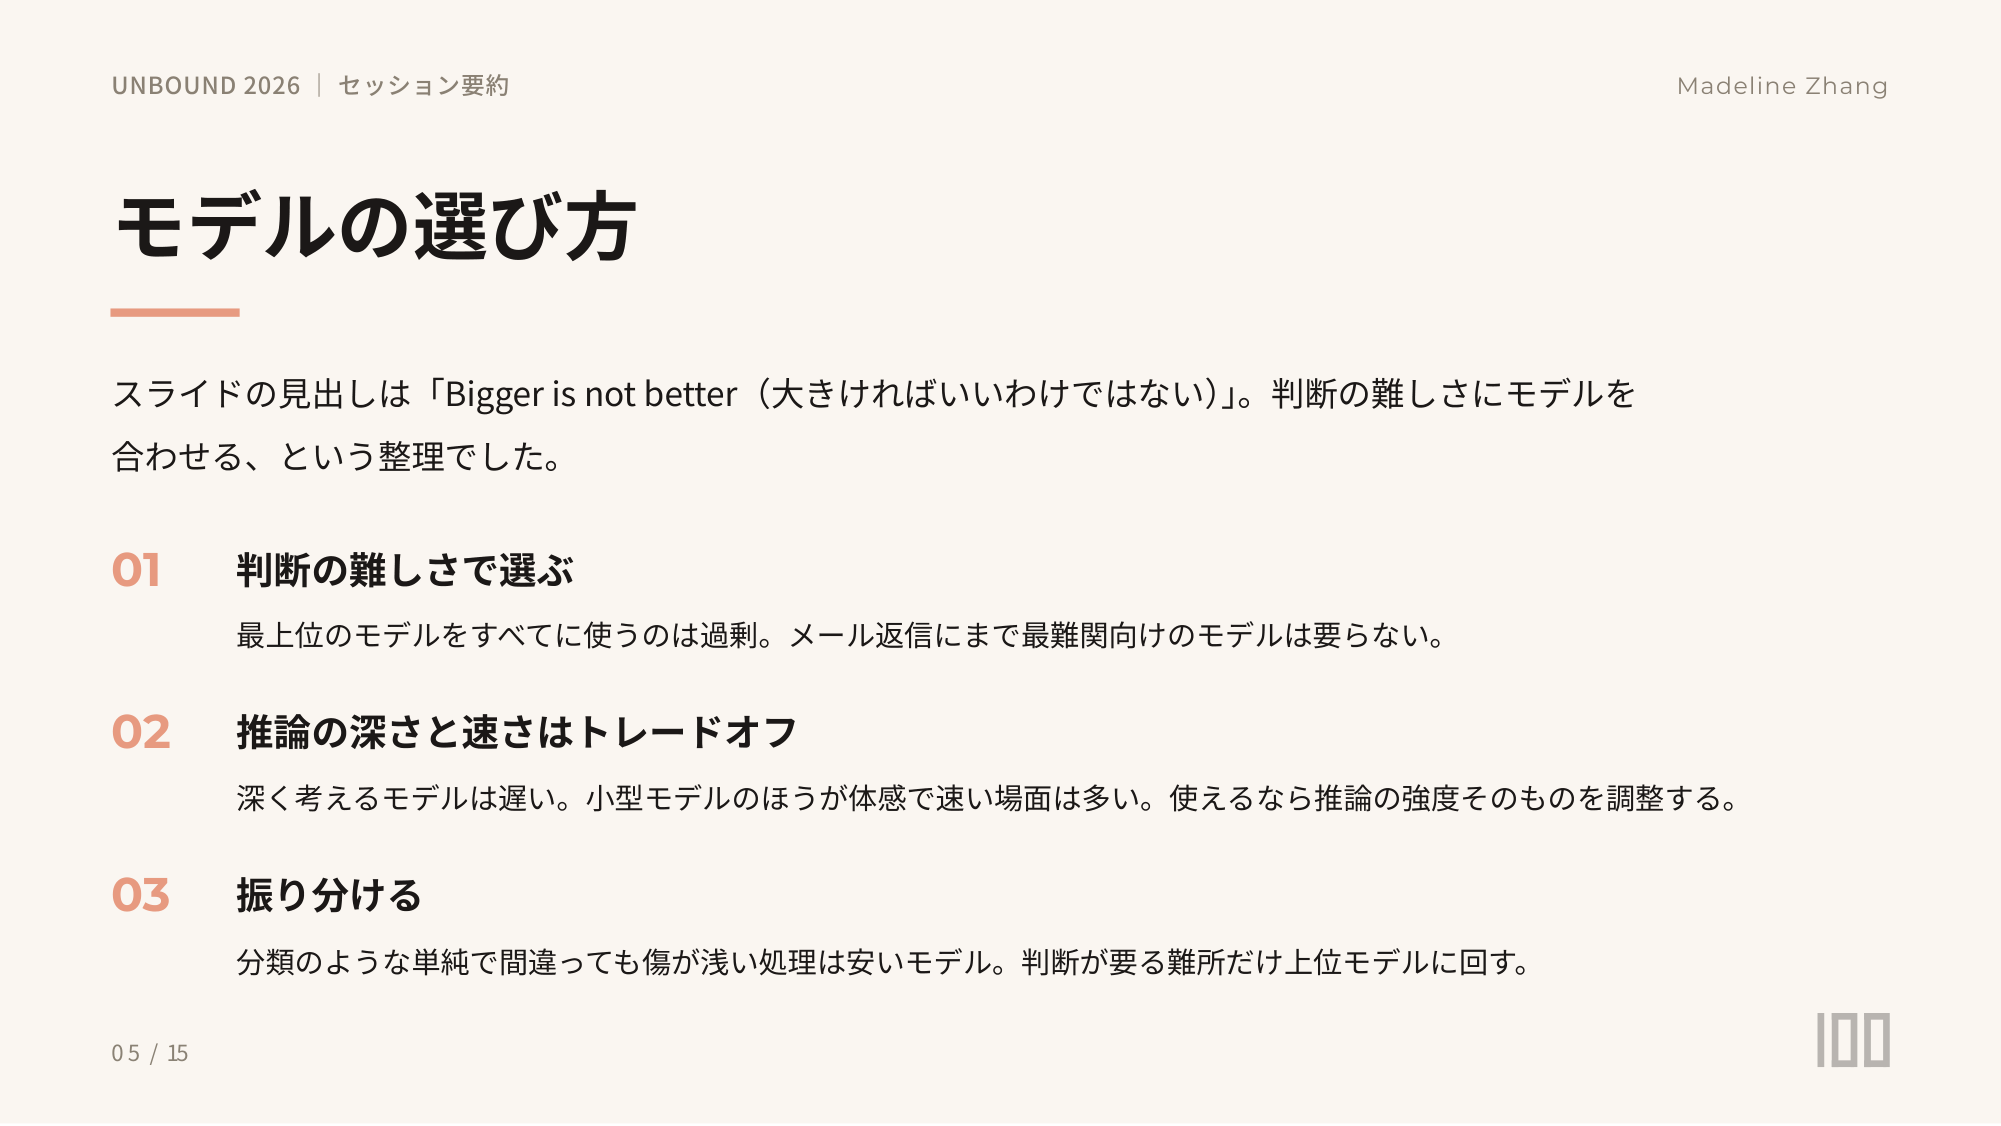
判断の難易度にAIモデルを合わせ、システムプロンプトの5項目とツールの説明文を明確に定義します。
Zhang氏は「AIモデルは規模が大きければよいとは限らず、判断の難易度に合わせるべき」と強調しました。例えば、単純なメール返信に最上位モデルは過剰です。深く推論するモデルは処理が遅く、小型モデルの方が速くて適している場面も多々あります。そのため、推論の強度を調整し、分類などの失敗しても影響が小さい処理は安価なモデルに、難所だけ上位モデルに振り分ける設計が推奨されます。
出典:株式会社100作成のセッションまとめ資料
また、「優秀な営業担当として売ってください」といった曖昧な指示では毎回結果がブレてしまいます。システムプロンプト(基本指示)には、以下の5項目を明確に記述します。
- Identity(役割): 何者として振る舞うか(例:シニアソフトウェアエンジニアなど)
- Objective(目的): 何をもってタスク完了とするか
- Boundaries(境界線): 禁止事項(例:CRMのレコードは直接変更しないなど)
- Escalation rules(引き継ぎ条件): 人間に判断を仰ぐ条件(例:金額が上限を超えたら止めるなど)
- Output contract(出力形式): 検証やログ観測のために固定する出力フォーマット
AIに持たせる「ツール」は、「関数」「スキーマ」「説明文」の3点セットで構成され、特に「説明文の質」がコストに直結します。 説明が曖昧なまま30個のツールを渡すと、AIは片端からツールを試してしまい、トークン(利用料)と時間を浪費します。遠回りしても最終的に正解に辿り着いてしまうため、この無駄には気づきにくいという注意点も挙げられました。
さらに、エラー文は「AIが次の手を判断するための材料」として分かりやすく記述し、万が一ツールが二重に呼び出されても顧客に同じメールが何百通も送信されないよう、重複実行を防ぐ設計(冪等性:べきとうせい)を持たせることが重要です。
メモリと人の関与、複数エージェントはどう組むのか?
メモリは4層に分け、人の関与は4段階の低いレベルから始め、まずは「1体のエージェント」でシンプルに組み立てます。
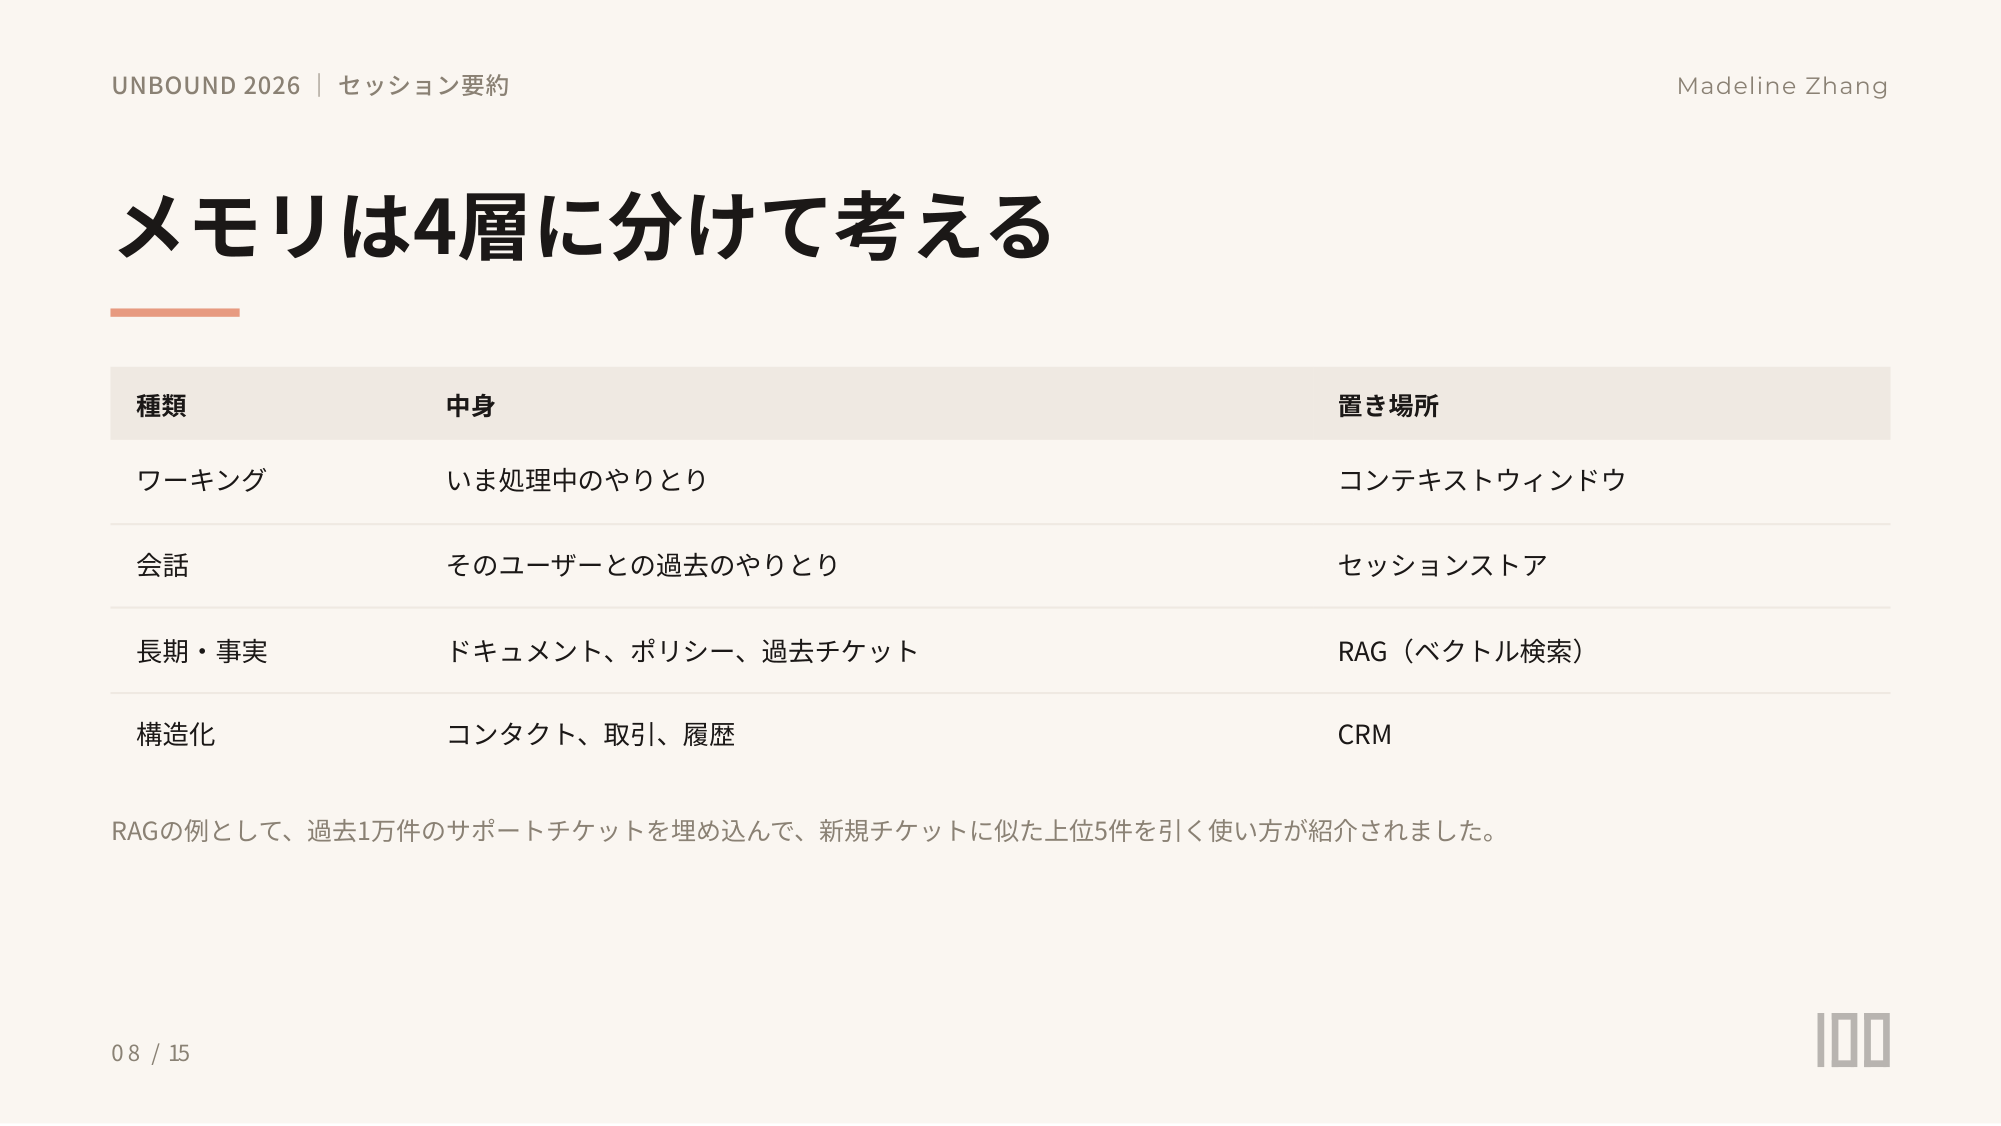
Zhang氏は、AIが扱うメモリ(記憶)を以下の4層に整理しました。検索拡張生成(RAG)の具体例としては、過去1万件のサポートチケットをベクトル化して保存し、新規チケットに類似した上位5件を抽出する使い方が紹介されました。
- ワーキングメモリ: 現在処理中のやりとり(コンテキストウィンドウ)
- 会話メモリ: 過去のやりとり(セッションストア)
- 長期・事実メモリ: 社内文書、規定、過去のチケット(RAG)
- 構造化メモリ: 顧客情報、取引、活動履歴(CRM)
出典:株式会社100作成のセッションまとめ資料
AIが一度に扱える情報量(コンテキスト)は、上限の半分に達したあたりで過去のやりとりがノイズとなり、判断力が鈍ることがあります。そのため、上限に達するのを待たず、先回りして会話を要約・圧縮し、リフレッシュした状態で処理を再開する工夫が必要です。
また、業務に対する「人の関与(Human-in-the-loop)」は次の4段階に分けられます。人間の確認を挟むべき条件は「取り消せない」「社外に出る」「金額が閾値を超える」「AIの確信度が低い」「見慣れない状況」の5つであり、まずはObserve(観察)から始め、徐々にDraft(下書き)へと段階を上げていく進め方が推奨されました。
- Observe(観察): 読み取り専用で裏側で動かし、実際の操作は何も実行しない
- Draft(下書き): 下書きの作成までをAIが行い、最終的な送信は人が行う
- Approve(承認): 基本はAIが実行するが、リスクの高い操作は人が事前承認する
- Autonomous(自律): すべてAIが実行し、人は後から抜き取り形式で監査する
複数エージェントの構成パターンには、1体で完結する「Single」、依頼内容を判定して検索や予約などの専門AIへ振り分ける「Router」、各AIが独自のループを持ち調整役が進捗を管理する「Multi-Agent」の3つがあります。実際には多くの業務が「Single」で事足りるとし、Routerを使う際は「文脈を持たない相手に丸投げしないこと」、また「Multi-Agentが常に最適とは限らないこと」が強調されました。
構築後の品質管理と、不具合への対処はどう進めるのか?
評価(テスト)と可観測性(ログの追跡)を備え、典型的な不具合に備えます。
構築後に不可欠な仕組みとして、Zhang氏は「評価(EVALS)」と「可観測性(OBSERVABILITY)」の2つを挙げました。
- 評価(EVALS): AIの出力は毎回同じにならないという前提で組むテストです。入力と期待する出力の「基準セット(正解データ)」を用意し、ツールの追加やプロンプト修正のたびに全件テストを回します。出力形式が固定でないものは、別のAIモデルに採点させます。
- 可観測性(OBSERVABILITY): ツールの呼び出し、プロンプト、結果、応答時間、トークン消費量をすべて記録し、「最終出力の正誤」ではなく「どのステップで最初に誤った判断をしたか」を特定できる状態を指します。成功率が90%でも、毎日大量に回る業務であれば失敗は大きく積み上がってしまいます。
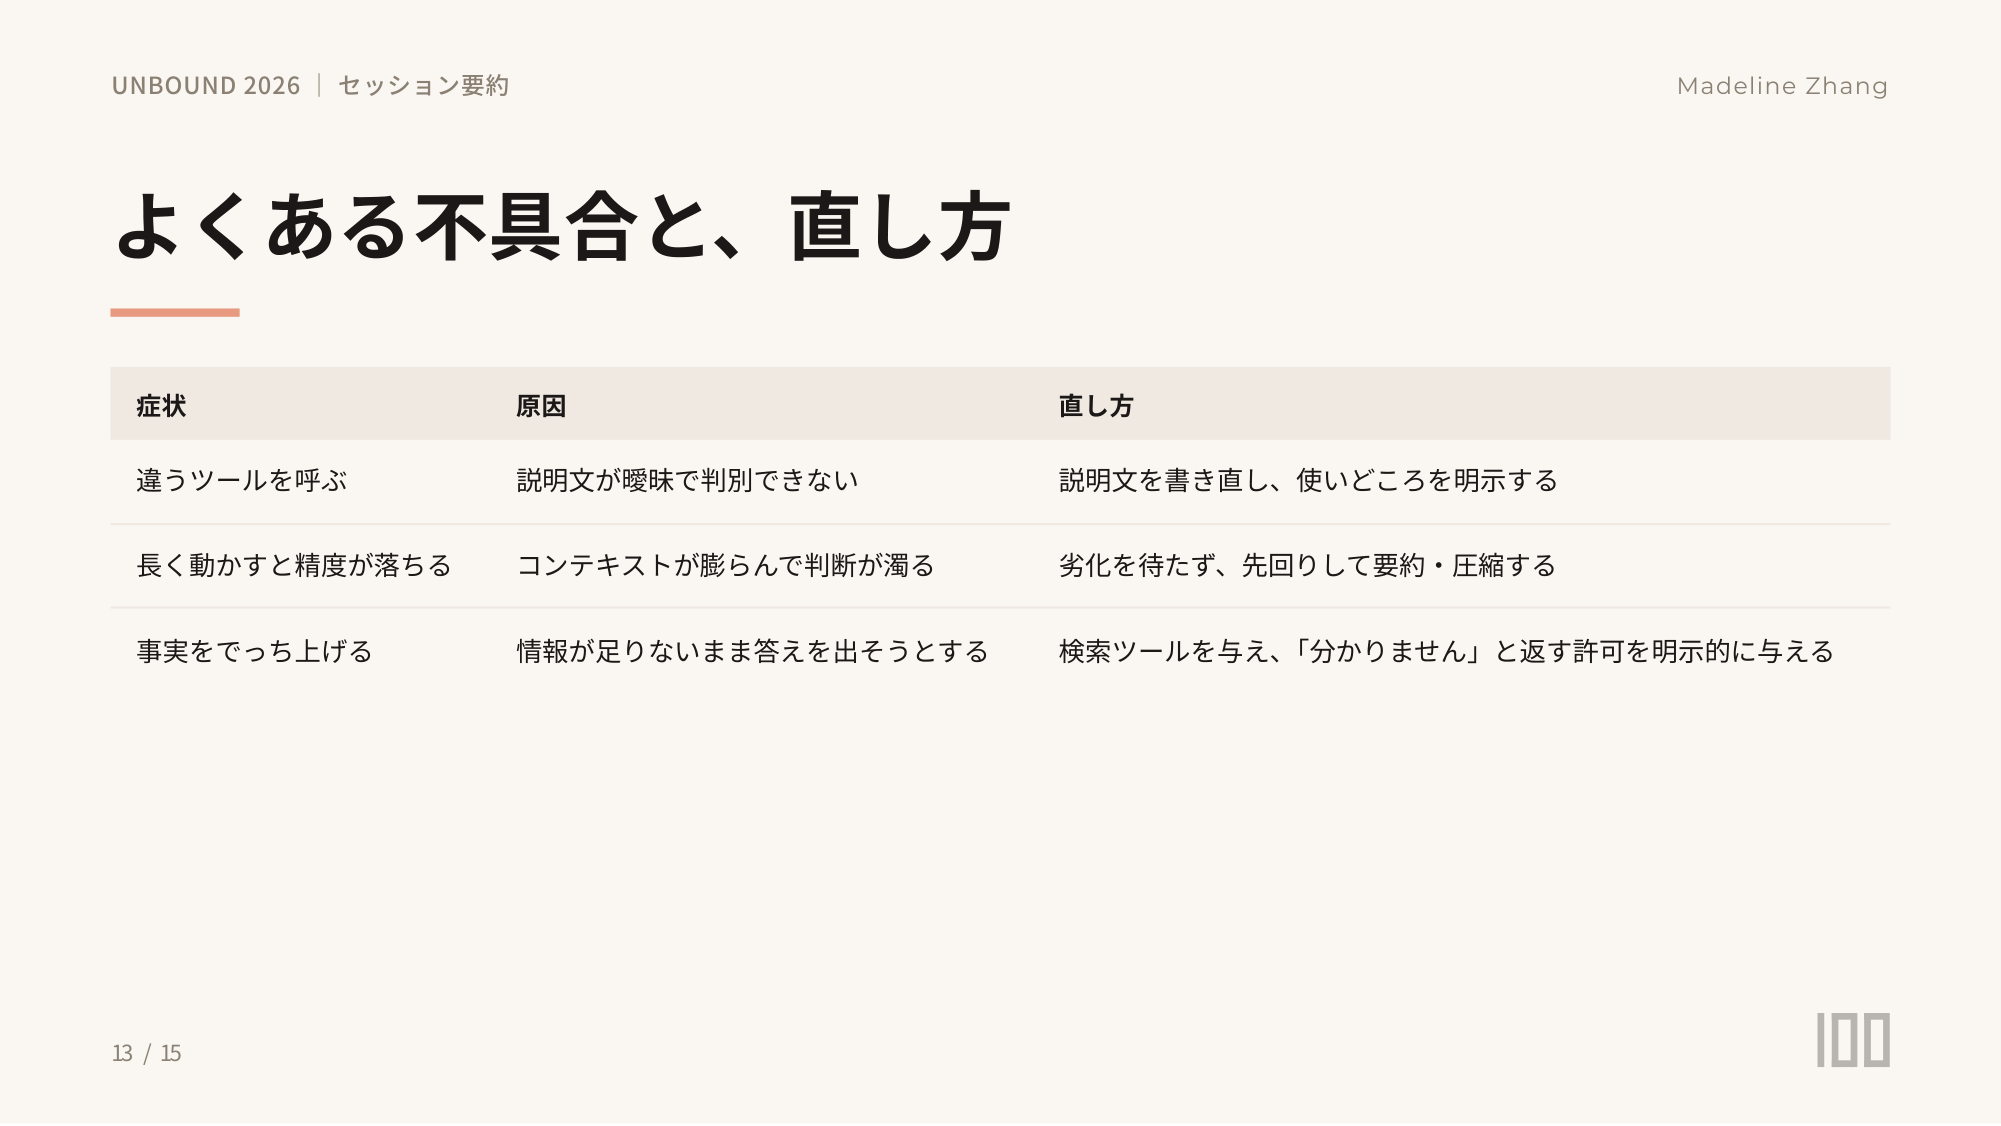
あわせて、よくある不具合と対処法も示されました。代表的なものは以下の3つです。
- 間違ったツールを呼ぶ: ツールの説明文が曖昧なため。説明を書き直し、使いどころを明示する。
- 長く動かすと精度が落ちる: 文脈(履歴)が膨らみすぎているため。先回りして要約・圧縮する。
- 事実をでっち上げる(ハルシネーション): 情報が不足しているため。検索ツールを与えたうえで、情報がない場合は「分かりません」と答える許可をプロンプトで与える。
出典:株式会社100作成のセッションまとめ資料
セッションの最後には、HubSpotの「Agent Builder」を用いて商談予約エージェントを1体構築するデモ映像が紹介されました。ツールとCRM情報を連携させ、Identity(役割)、エスカレーション条件、出力スキーマを定義すると、AI側からも必要なツールや情報を提案してくれます。カレンダー連携によって翌朝8時の会議招待が自動作成され、その裏側の思考プロセスを実行ログで詳細に追跡できる様子が実演されました。
株式会社100の解説:日本のHubSpotユーザーはどう実践すべきか?
ここからは、本セッションの内容を踏まえた株式会社100の独自解説です。日本のビジネス環境において、HubSpotでどう実践に移すべきか3つの視点で整理します。
1. HubSpotの「ワークフロー」と「AIエージェント」を5条件で使い分ける
日本企業には、稟議や定型的な社内承認など、手順が厳密に決まっている業務が多く存在します。Zhang氏の基準に照らし合わせると、手順が毎回同じでミスの許されない業務は、無理にAI化せずHubSpotの「ワークフロー機能」で確実に自動化するのが最適です。
一方で、「顧客からの問い合わせ内容によって参照すべき資料や回答ルートが変わる」といった業務であれば、前述の「5つの条件」のうち3つ以上に当てはまるかを確認したうえでAIエージェント化を検討すると、構築・保守のコスト対効果を高められます。(※利用にあたっては、現在契約中のHubSpotプランで対象機能が使えるかを事前にご確認ください)
2. CRMのプロパティとサポート履歴を「4層のメモリ」として整える
セッションでは、構造化メモリは「CRM」、長期メモリは「過去のチケットや文書」と定義されました。日本企業のデータ環境でよく見られる課題として、担当者によって社名(株式会社の有無など)や部署名の表記が揺れたり、入力ルールが徹底されていなかったりするケースが挙げられます。
参照元のデータが乱れているとAIの判断精度も落ちてしまいます。まずはHubSpot CRMのプロパティ名や入力ルールを整備すること、そして誤って既存データを壊さないよう、システムプロンプトの禁止事項(Boundaries)で「CRMのレコードを直接変更しない」と明確に境界線を引くことが、安全なAI活用の土台となります。
3. 「Observe」や「Draft」から小さく始め、変更のたびに評価を回す
日本の商習慣において、顧客への連絡ミスや誤送信は企業の信頼に大きく関わります。「社外に出る操作には人の確認を挟む」という基準にならい、最初は読み取り専用の「Observe(観察)」や、下書き作成までの「Draft」レベルからスモールスタートするアプローチを推奨します。
まずは「Single(1体のエージェント)」で小さく構築し、プロンプトやツールを修正するたびに基準データで評価(テスト)を回し、実行ログから「AIが最初にどこで判断を誤ったか」を追跡できる運用体制を整えることが成功への近道です。
よくある質問(FAQ)
Q1. AIエージェントと従来の自動化(ワークフロー)はどう使い分けますか?
Zhang氏は「手順が同じでミスの代償が大きい業務は自動化を使い、進め方が複数あるなど5条件の3つ以上に当てはまるときだけAIエージェントを作る」と示しました。株式会社100としても、定型処理はHubSpotの「ワークフロー」で確実に組み、状況によって道筋が分かれる複雑な業務に絞ってAIエージェントを検討する進め方を推奨します。
Q2. システムプロンプトやツールの設計で気をつけることは何ですか?
プロンプトで「役割」や「禁止事項」など5項目を明確に定め、ツールは説明文を具体的に書いて重複実行を防ぎ、曖昧なまま大量のツール(例:30個など)を渡さないことが重要です。HubSpotのCRMと連携する際も、「レコードを勝手に変更しない」等の禁止事項を明記し、最初は渡すツールを最小限に絞ってテストすることをおすすめします。
Q3. 会話が長くなるとAIの記憶や判断力が劣化する問題には、どう対処すればよいですか?
メモリを4層に分け、顧客データなどの構造化データはCRMに置き、やりとりが上限の半分ほどに進んで判断が鈍る前に「先回りして要約・圧縮する」方法が有効です。また、AIの参照先となるHubSpotのCRM項目や過去チケットの表記ゆれを日頃から整えておくことも、精度維持に直結します。
Q4. 本番環境に移す前や運用中に、どうやって品質を担保しますか?
人の関与を「Observe(観察)」から「Draft(下書き)」へと段階的に引き上げ、設定変更のたびに基準データで評価(テスト)を回し、ログから最初の誤判断を探す「可観測性」を確保することが重要です。特に社外(顧客)に出る連絡ほど人間による承認ステップを残し、実行ログを確認しながら少しずつ自律化の範囲を広げていく運用が安全です。
まとめ
本セッションでは、従来の自動化とAIエージェントを使い分ける判断基準から始まり、システムプロンプト、ツール、4層のメモリ、人の関与、評価と可観測性に至るまで、AIを実用的なプロダクトへ昇華させるための設計手順が体系的に示されました。手順が毎回同じ定型業務はHubSpotの「ワークフロー」で確実に自動化し、顧客からの問い合わせ対応など道筋が複数ある業務に絞ってAIエージェントを構築することで、構築・保守のコスト対効果を高められます。まずはAIの記憶領域となるCRMのプロパティや入力ルールを整え、読み取り専用の「Observe(観察)」や下書き作成までの「Draft」といった安全な段階から小さくテストを始めてみてはいかがでしょうか。
株式会社100では、日本の商習慣に合わせた「ワークフロー」と「AIエージェント」の適切な使い分けの整理から、AIの判断精度を高めるためのCRMデータの整備、人の確認を挟みながら安全に小さく導入・評価を回す運用体制の構築まで、実践的なHubSpot活用を一貫してご支援しています。「自社の業務はワークフローとAIエージェントのどちらで自動化すべきか判断できない」「AIの参照元となるCRMのプロパティや入力ルールが整っておらず、どこから手をつければよいかわからない」といったお悩みをお持ちの方は、ぜひお気軽にご相談ください。
松本 暁王
テレビ業界でキャリアをスタートし、その後WEBディレクターへ転身。サイトの企画・設計から運用まで、事業者側の視点でものづくりに向き合ってきました。2025年8月に株式会社100へ入社し、現在はForward Deployed Engineer(FDE)として、お客さまの現場に入り込みながらAIの導入・活用を伴走支援しています。技術を技術のまま終わらせず、日々の業務で実際に使える形に落とし込むことを大事にしています。
この記事をシェアする


https://hubspot.100inc.co.jp/unbound-2026-prompt-to-product
コピーWe are HubSpot LOVERS
ビジネスの成長プラットフォームとしての魅力はもちろん、
HubSpotのインバウンドマーケティングという考え方、
顧客に対する心の寄せ方、ゆるぎなく、そしてやわらかい哲学。
そのすべてに惹かれて、HubSpotのパートナー、
エキスパートとして取り組んでいます。
HubSpotのこと、マーケティング設計・運用、
組織の構築など、どんなことでもお問い合わせください。