HubSpotの年次カンファレンス「UNBOUND 2026」のセッション「Tools for Growth: Eliminating Marketing Data Silos」をレポートします。前半ではセッションの要点を整理し、後半では株式会社100の視点から、日本のHubSpot活用企業がどのように実務へ取り入れるべきかを解説します。
この記事のポイント
- マーケターが直面している本質的な課題は「キャンペーン」ではなく「データ」にあります。データを1か所に集約して定義をそろえることが、高度な分析やAI活用の土台となります。
- 集約したデータをデータウェアハウスで分析し、離脱リスクの高い層をセグメント化して、エンジニアの工数をかけずにHubSpotへ書き戻す一連のフローが実演されました。
- 株式会社100の見解として、外部のデータ基盤を検討する前に、まずはHubSpotの「Data Hub」やカスタムプロパティを活用し、社内のデータ定義を統一するステップを推奨します。
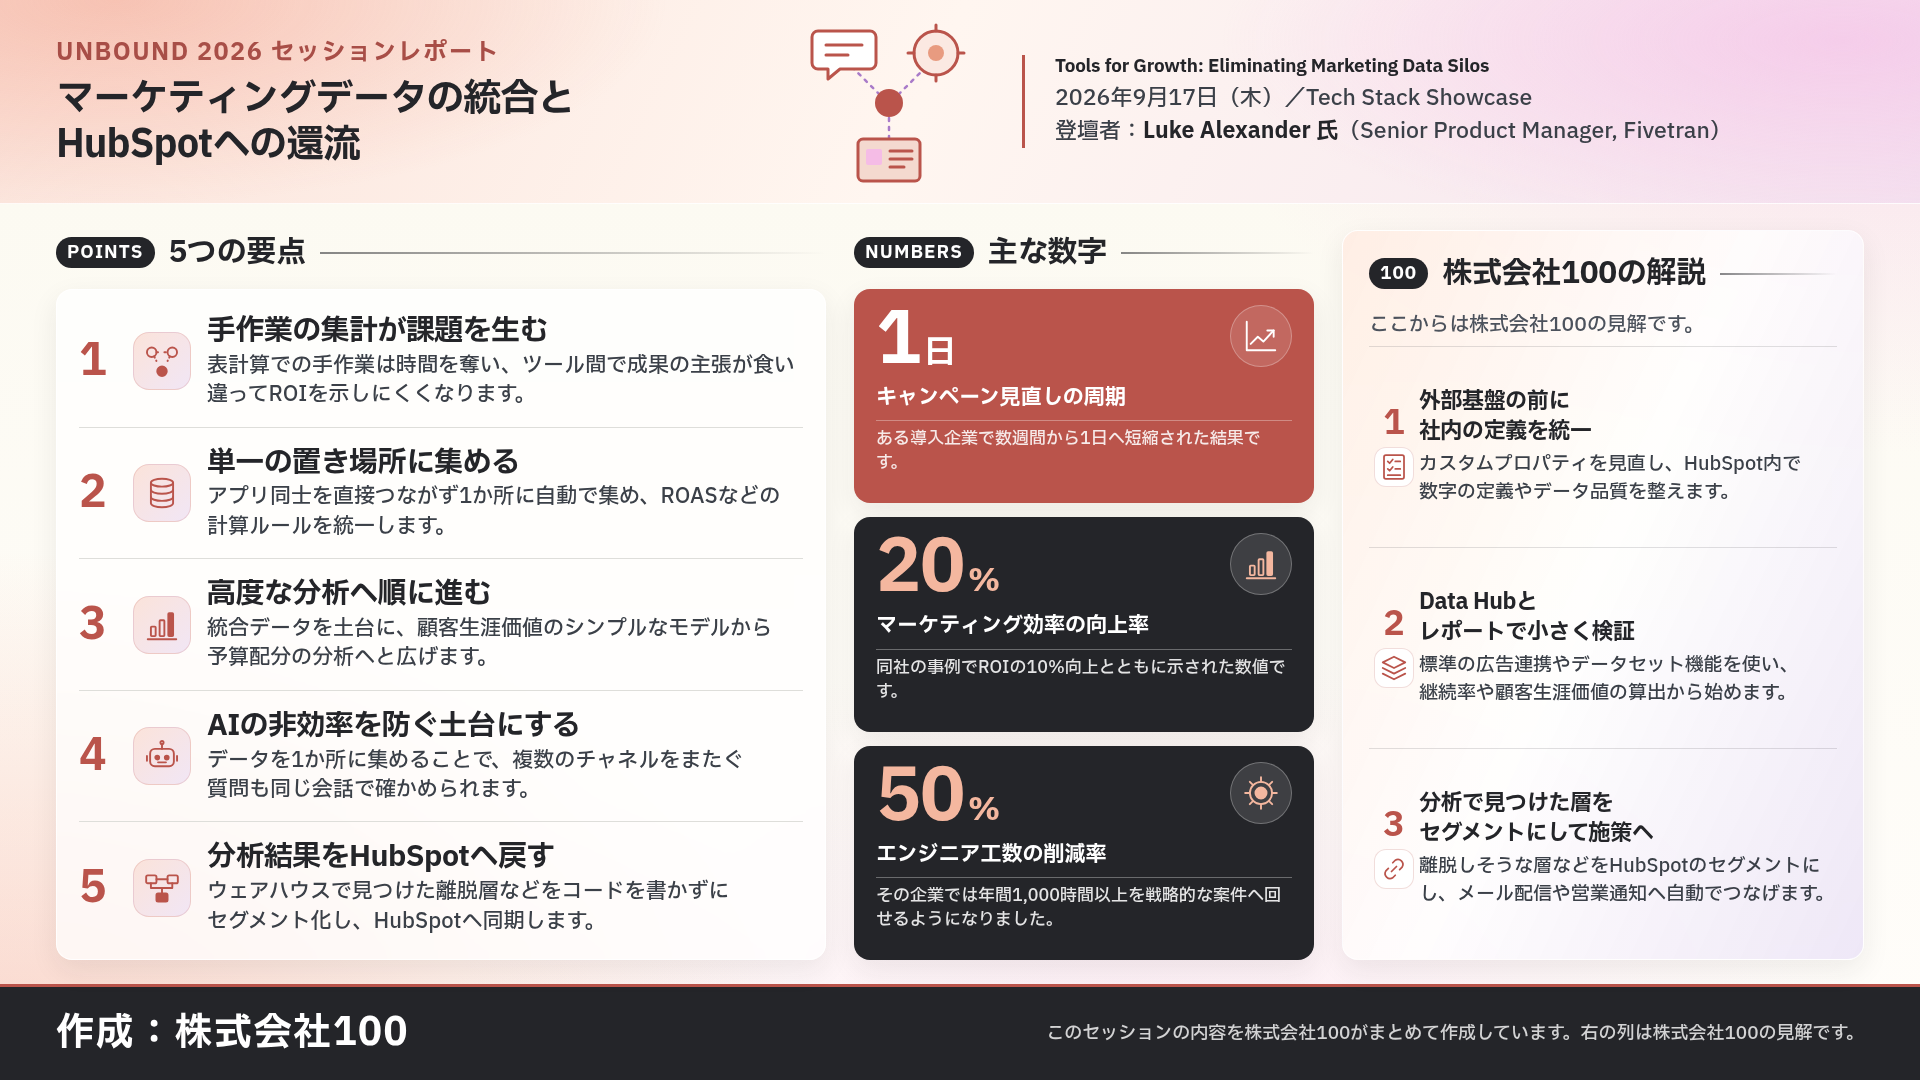
出典:株式会社100作成のセッションまとめ資料
セッション情報
| 項目 | 内容 |
|---|---|
| セッション名 | Tools for Growth: Eliminating Marketing Data Silos |
| 会場 | Tech Stack Showcase(出展企業の紹介枠) |
| 開催日 | 2026-09-17 |
| 登壇者 | Luke Alexander 氏(Senior Product Manager, Fivetran) |
※本記事のセッション内容は株式会社100が要約したものであり、後半の「株式会社100の解説」は当社の独自見解です。
セッションの詳細は、株式会社100が作成したまとめ資料(PDF)でもご覧いただけます。まとめ資料を開く(PDF)
---
なぜマーケティングのデータはサイロ化するのか?
ツールごとにデータが分断され、手作業での集計によって数値の食い違いが生じるためです。
Fivetranでマーケティング分析の製品戦略を率いるLuke Alexander氏は、「現代のマーケターが抱えているのは、キャンペーンの課題ではなくデータの課題だ」と指摘します。いまだに表計算ソフトを用いて手作業でレポートを作成している企業は多く、データのサイロ化(システムごとに情報が孤立し、連携できていない状態)が次の4つの課題を引き起こしています。
- レポート作成が表計算ソフトに依存している:毎週すべてのツールからCSV等をダウンロードして結合する手作業が続き、本来の「分析」に時間を割けません。
- プラットフォームごとに成果の主張が食い違う:広告の反応とHubSpotのメール結果が別々に集計され、各ツールが「自社の成果で成約した」と主張するため、正確な評価ができません。
- 購買プロセスの分断とデータ準備の負担:顧客の購買行動(カスタマージャーニー)が途切れ、分析そのものよりもデータの前処理に時間を奪われます。
- 投資対効果(ROI)を証明しにくい:データの根拠が揺らぐため、マーケティングのROIを経営陣や他部門へ自信を持って提示できません。
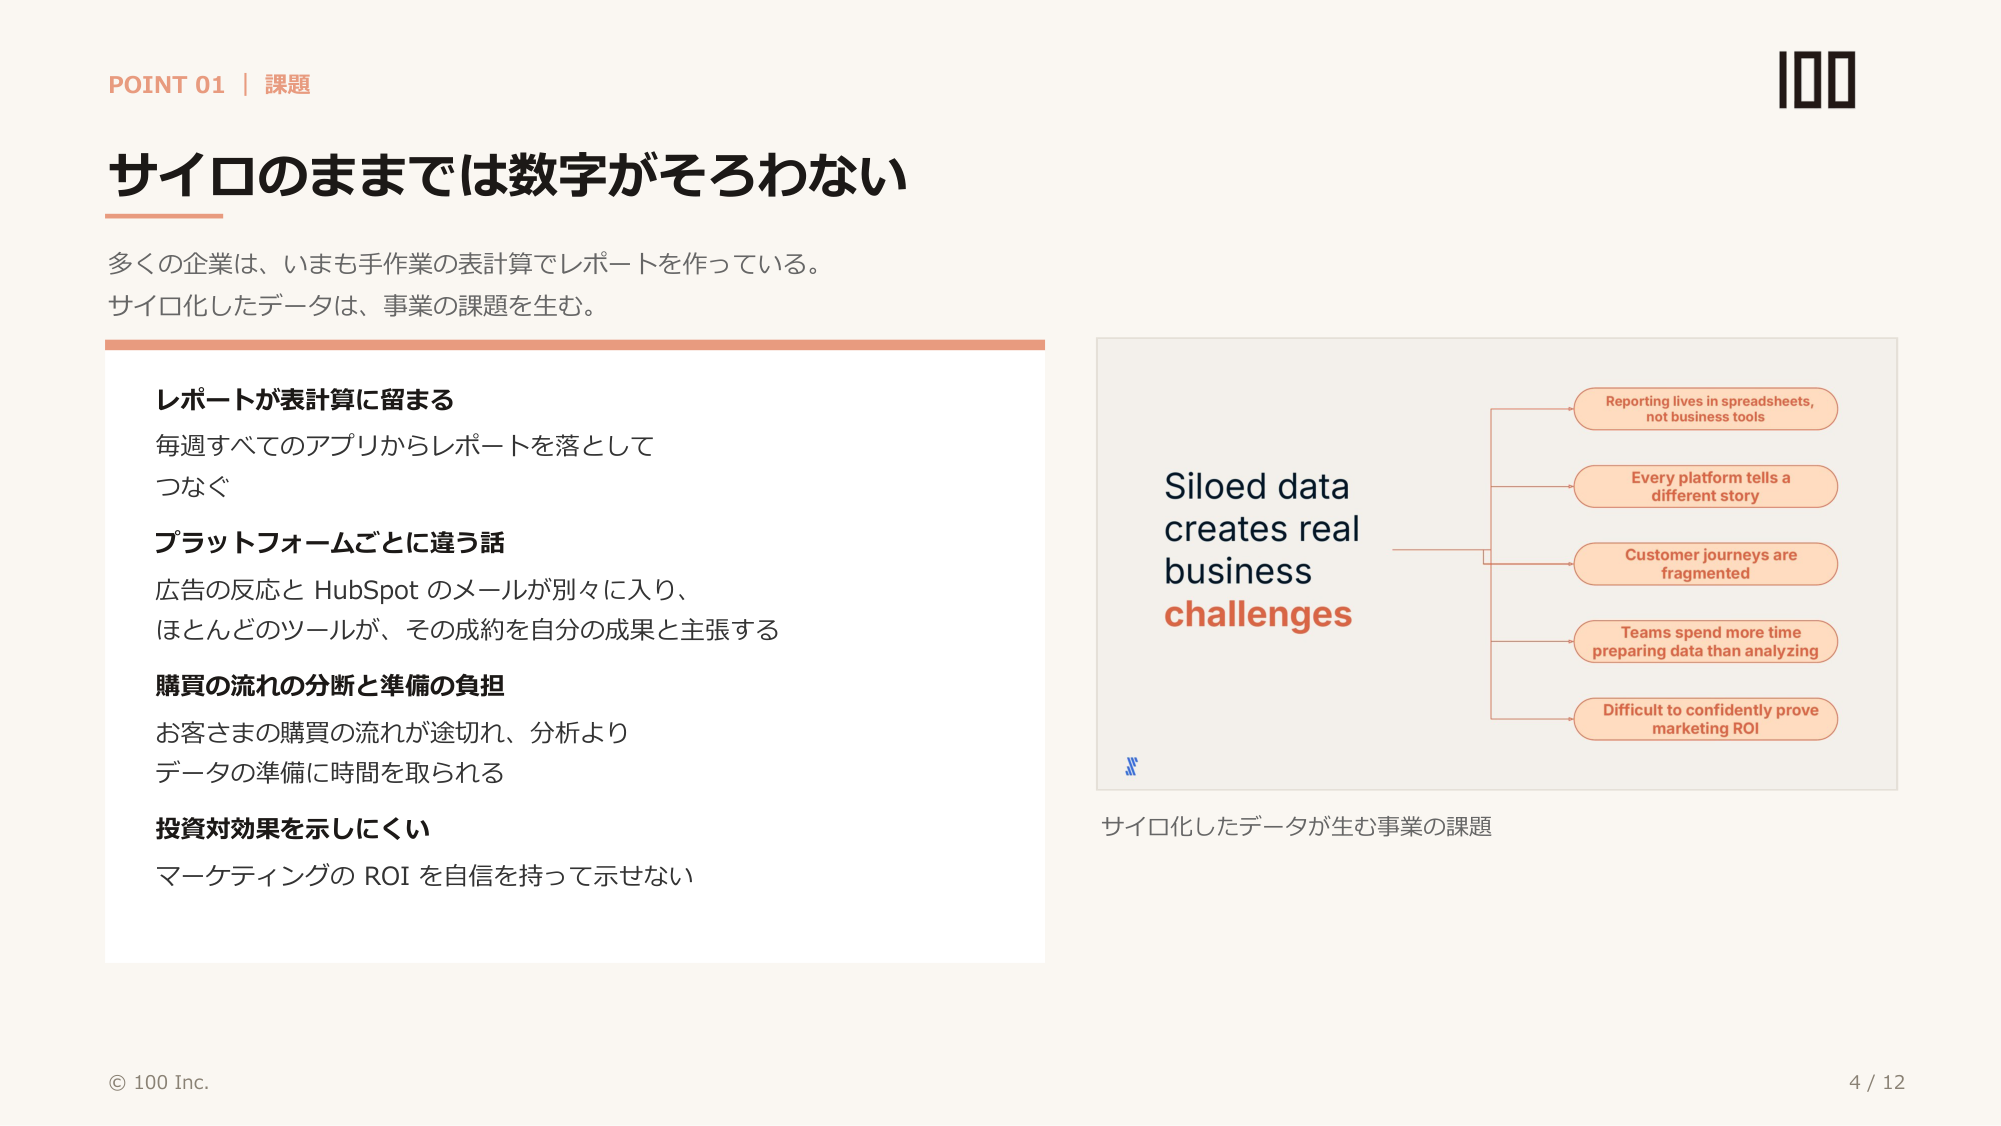
出典:株式会社100作成のセッションまとめ資料
---
散らばったデータをどう集め、どんな分析へ進むのか?
アプリ同士を直接つながずに「単一のデータ基盤」へ自動で集約し、数値の定義を統一します。
解決策としてAlexander氏が推奨したのは、各ツールのデータを自動で取り込み、単一のデータ基盤(データウェアハウス)に集約する構成です。自前でデータ連携のパイプラインを構築しようとすると、データソースを1つ追加するだけでも数週間の作業が発生します。また、アプリ同士を1対1で直接つなぐ構成では、連携がスパゲッティのように複雑に絡み合ってしまいます。
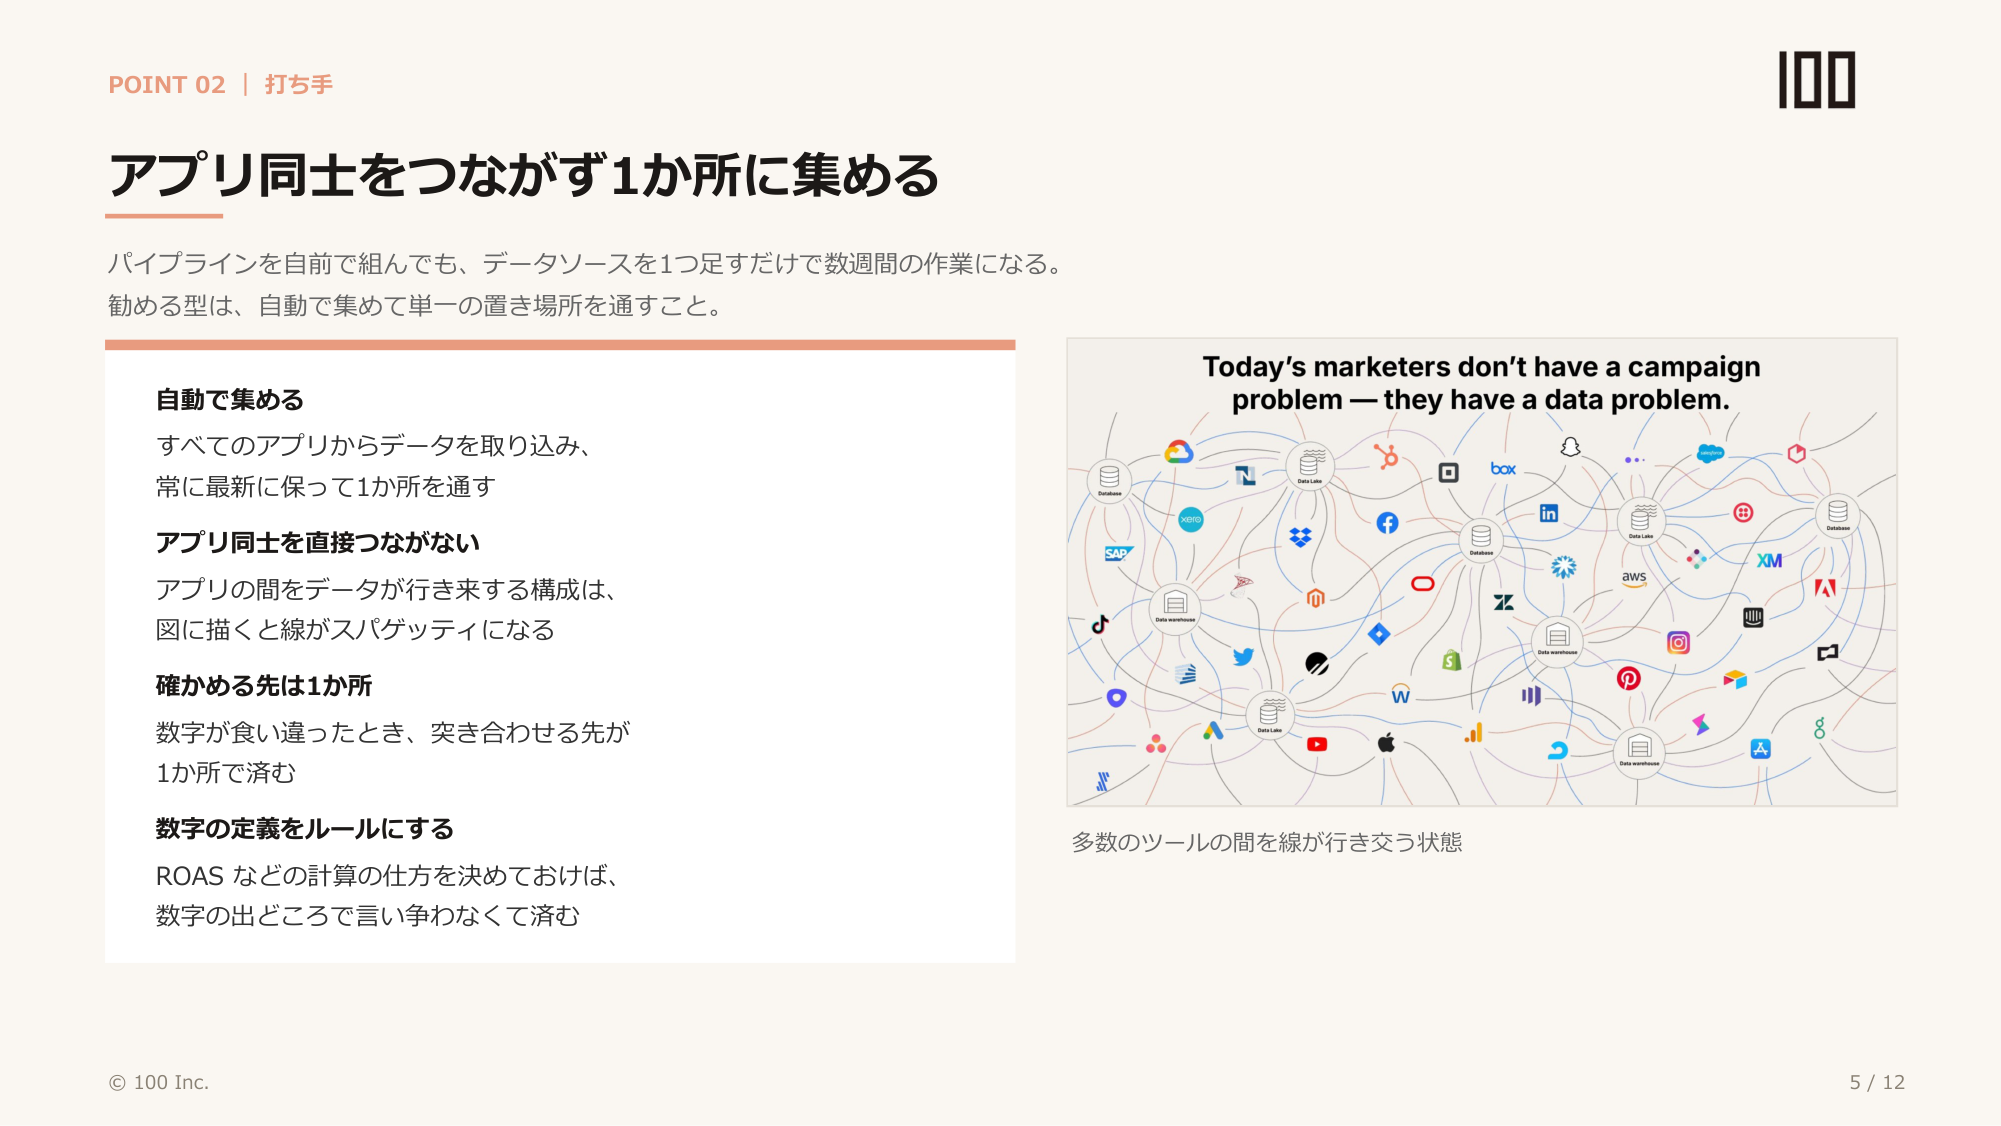
出典:株式会社100作成のセッションまとめ資料
Alexander氏が示したデータ統合の要点は、次の3つです。
- 自動で集約する:HubSpotやGoogle 広告、Meta広告、Amazon広告などのデータを常に最新の状態で抽出し、Snowflake、Databricks、BigQueryなどの単一のデータ基盤へ集約します。
- 参照元(Single Source of Truth)を1か所にする:ツール同士を直接つながずに1か所へ集めることで、数値が食い違った際に確認すべき場所が1つに絞られます。
- 数値の定義をルール化する:ROAS(広告費回収率)などの計算ロジックを基盤側で統一すれば、数値の出どころをめぐって社内で議論しなくて済みます。
Alexander氏は「一部を修正するたびに、議論で消耗する必要はありません。データはそこにあり、誰もが同じものを使えるのです」と強調しました。データが1か所に集まれば、早期に以下の4つの高度な分析が可能になります。
- 顧客生涯価値(CLV / LTV):1人の顧客が取引期間全体でもたらす利益の総額です。初回購入額だけでなく長期的な価値を測り、顧客獲得や維持の投資判断に活用できます。
- インクリメンタリティテスト:その施策が本当に事業へ貢献したのか、自然増を除いた「純粋な上積み効果」を測定する手法です。
- マーケティングミックスモデリング(MMM):統計的な手法を用いて、オンライン・オフラインを含む全チャネルの最適な予算配分を分析します。
- マルチタッチアトリビューション(MTA):購買に至るまでの過程で、どのチャネルの組み合わせがどのように貢献したかを可視化します。
Alexander氏は「顧客獲得単価(CPA)の引き上げについて財務チームと交渉したいなら、まずはシンプルなCLVのモデルを持っていくべきだ」と語り、最初の一歩としてCLVの算出から取り組むことを勧めました。
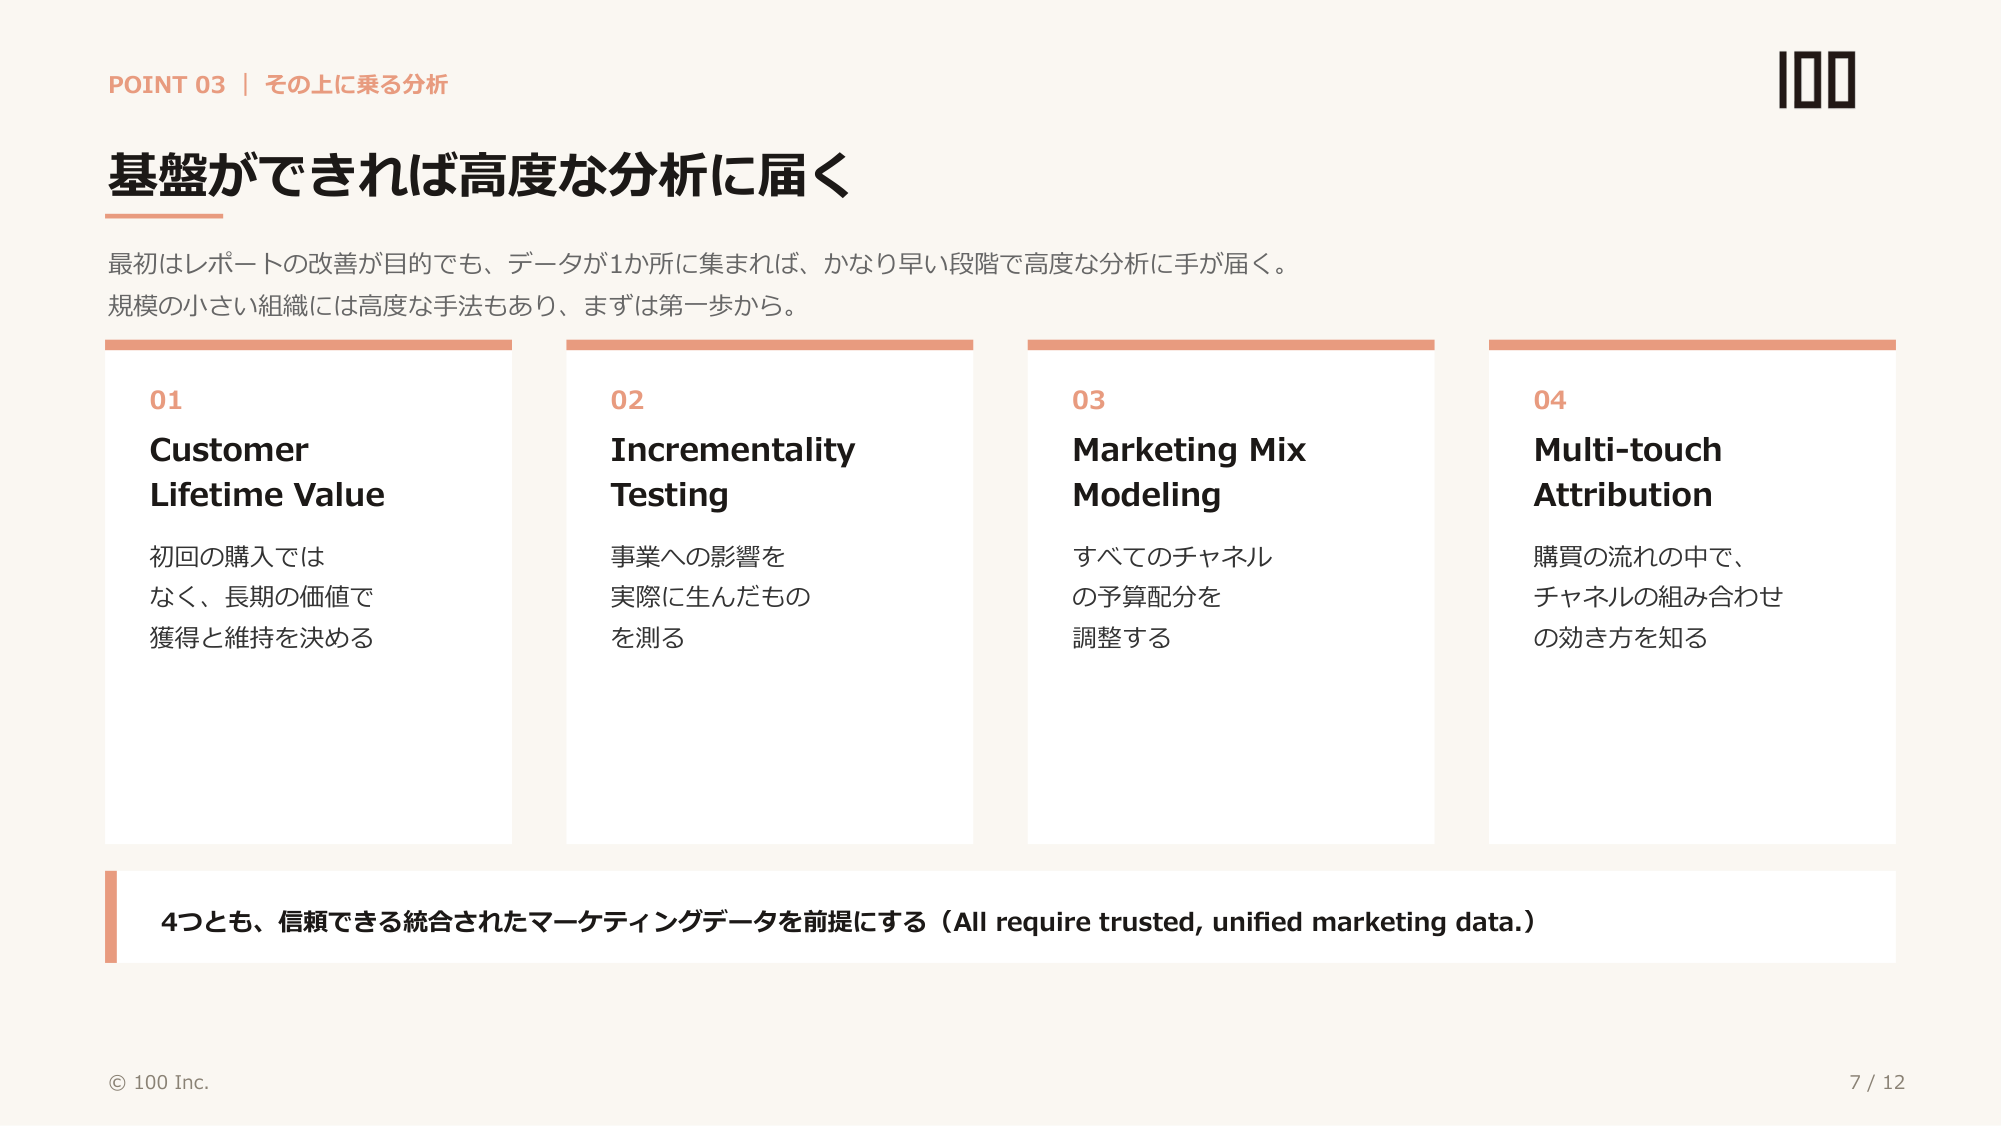
出典:株式会社100作成のセッションまとめ資料
---
AI活用や企業の現場ではどう役立っているのか?
共通のデータ基盤がAI活用の非効率を防ぎ、分析からHubSpotへの書き戻しまでを自動化します。
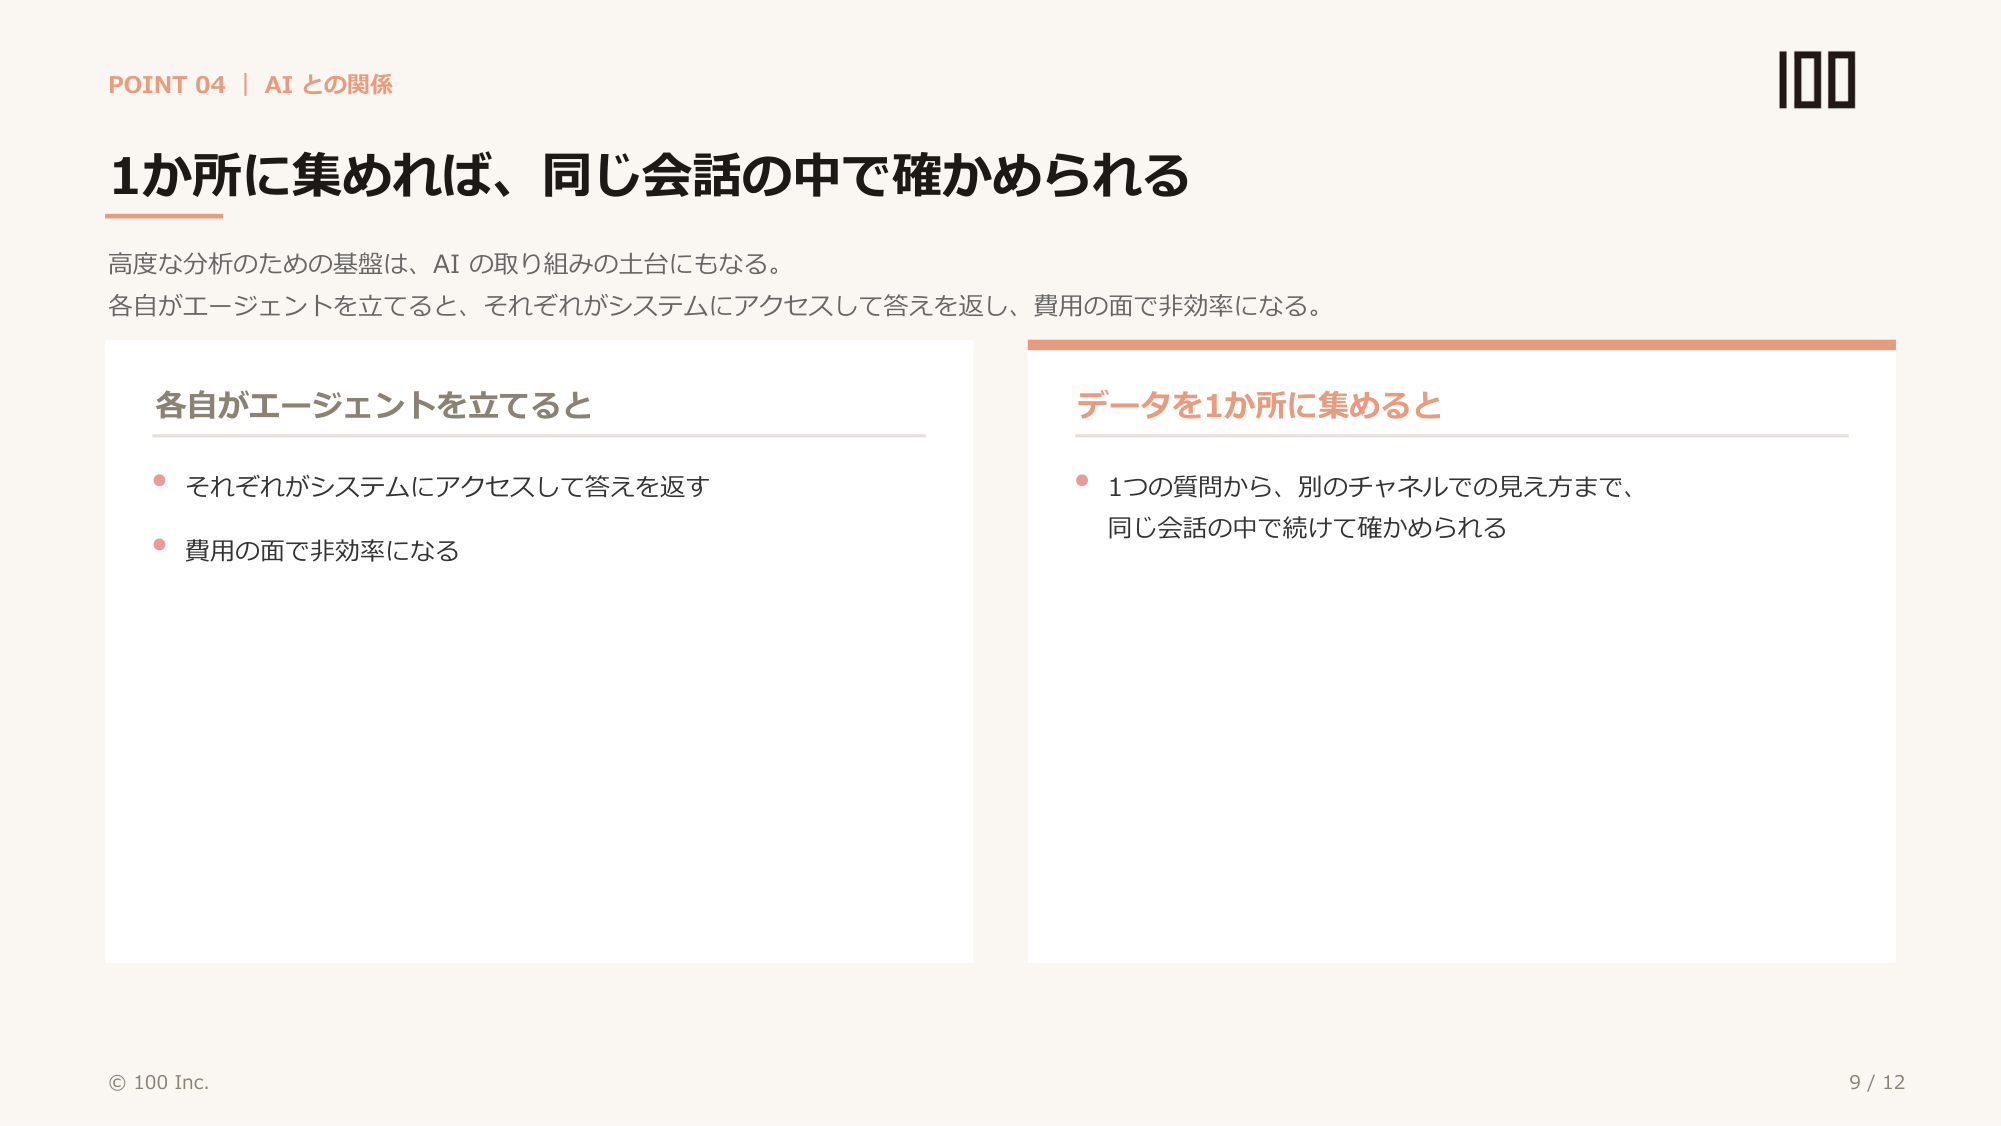
高度な分析のための基盤は、そのままAI活用の土台にもなります。社内の各部署が個別にAIエージェントを構築すると、それぞれが各システムへ個別にアクセスするため、コストやガバナンスの面で非効率です。データをあらかじめ1か所に集約しておけば、1つのチャット画面から複数チャネルを横断した質問を投げかけ、文脈を維持したまま深掘りできるようになります。
出典:株式会社100作成のセッションまとめ資料
データを一元化した事例として、Fivetranを導入したある急成長企業が紹介されました。同社はかつて手作業のデータ処理と10以上のデータソースの保守に追われていましたが、データ基盤の構築によって以下の成果を上げています。
- 改善スピードの向上:キャンペーンの見直し期間が数週間から1日へと短縮され、仮説検証のサイクルを1日で回せるようになりました。
- 効率とROIの改善:マーケティング業務の効率が20%向上し、ROIが10%改善しました。
- エンジニア工数の削減:データ保守などの工数を50%削減し、年間1,000時間以上をより戦略的なプロジェクトへ振り向けられるようになりました。
- データアクセスの向上:部門をまたぐデータの参照性が70%向上し、経営の意思決定スピードが2倍になりました。
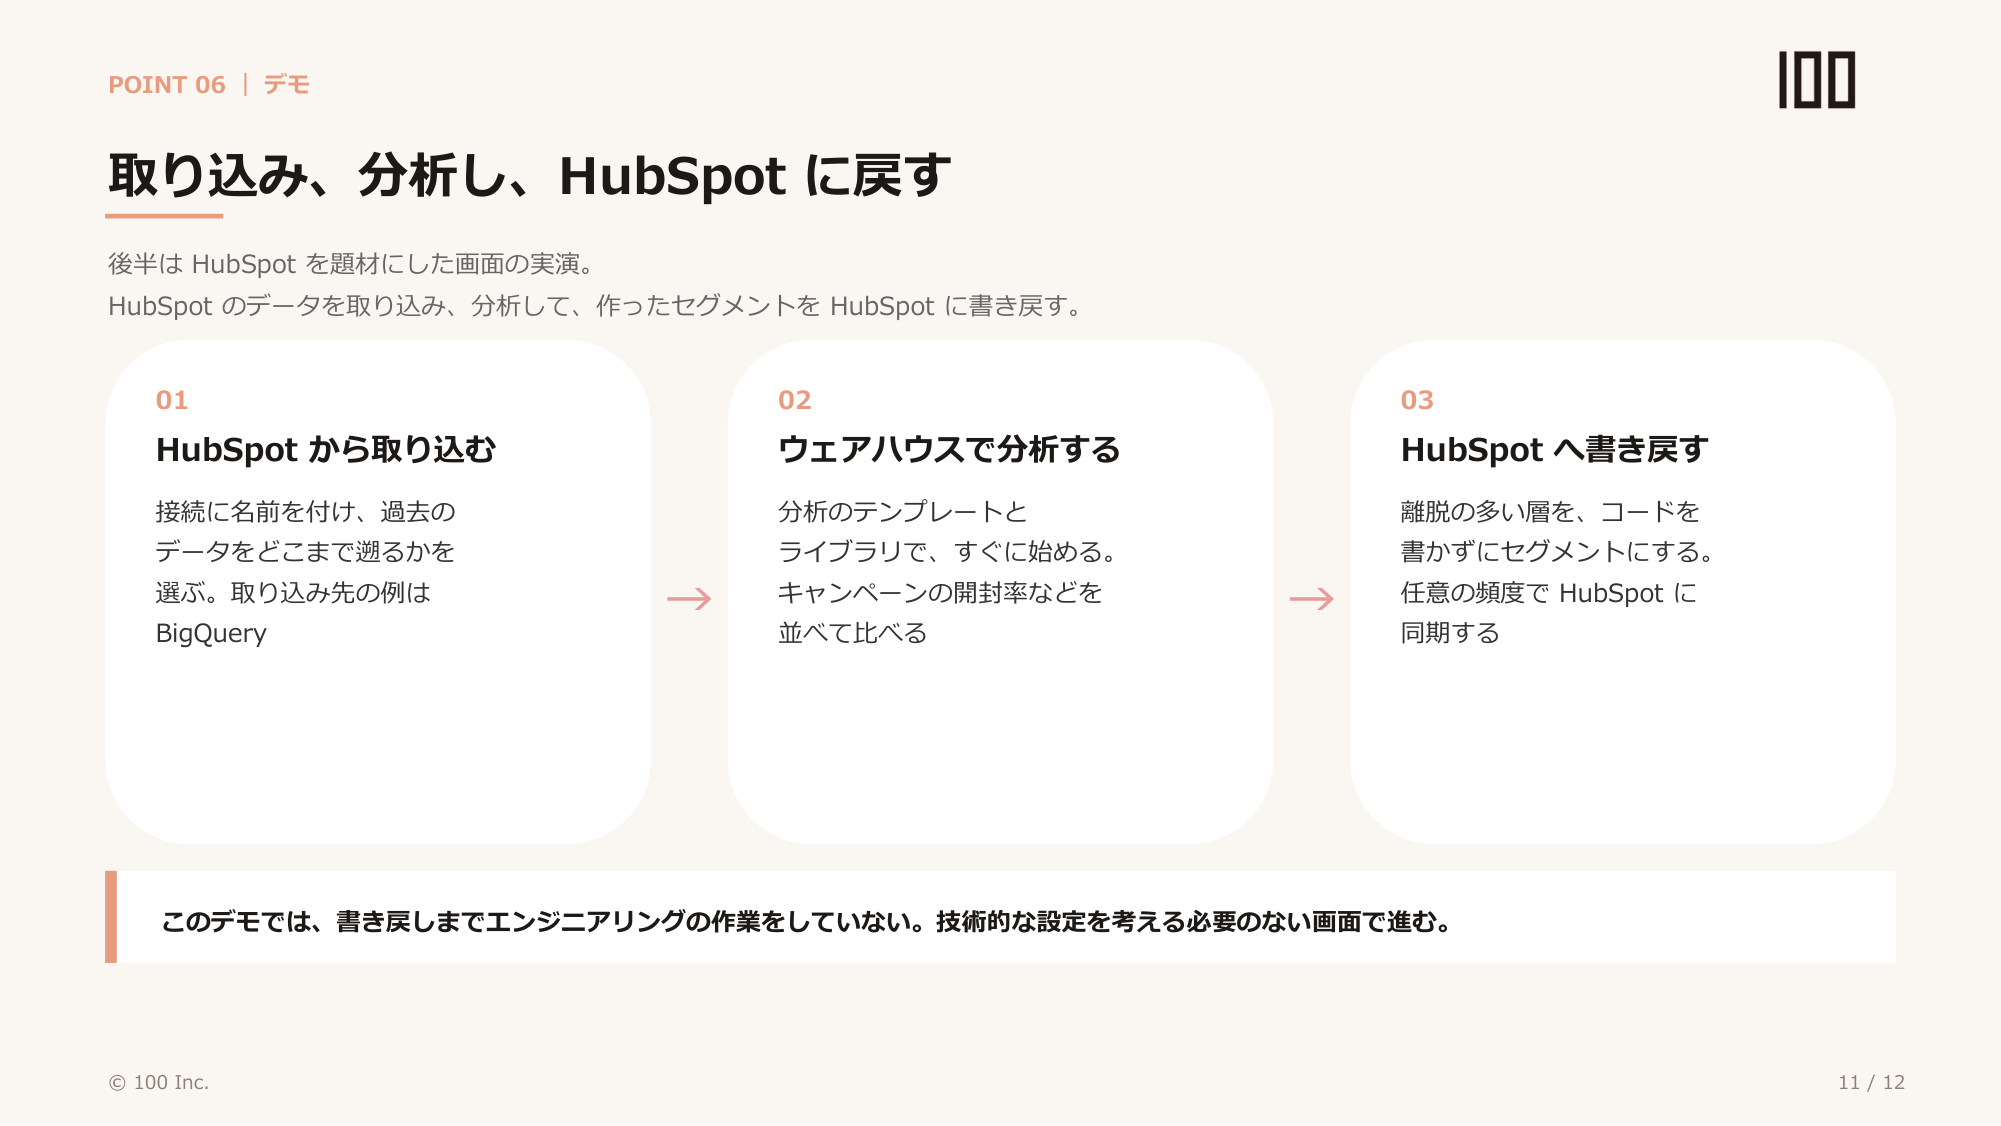
セッション後半では、HubSpotを題材にしたデモンストレーションが行われました。エンジニアリング作業を一切行わず、ノーコードで以下の3ステップを進める様子が実演されました。
- HubSpotからデータを取り込む:接続に名前を付け、過去データをどこまで遡って取得するかを選択します(デモでは格納先としてBigQueryを使用)。
- データウェアハウスで分析する:データを保管するウェアハウス側で、用意されたテンプレートとライブラリを使い、キャンペーンの開封率などを横並びで比較します。
- HubSpotへ書き戻す(リバースETL):分析によって特定した「離脱リスクの高い層」を、コードを書かずにセグメント(特定条件で絞り込んだ顧客リスト)化し、任意の頻度でHubSpotへ自動同期してすぐさま施策に活用します。
出典:株式会社100作成のセッションまとめ資料
株式会社100の解説:HubSpotでどう実践するか?
ここからは、日本のビジネス環境を踏まえた株式会社100の独自解説です。
1. 外部基盤を導入する前に、まずはHubSpot内の定義をそろえる
日本企業では、部署ごとに集計ルールが異なり「売上」や「成約」の定義が統一されていないケースが多く見受けられます。外部のデータウェアハウスを導入する前に、まずはHubSpotの「カスタムプロパティ」や「計算プロパティ」を見直し、社内で追うべき数値の定義を1つに定めることから始めましょう。 また、ご契約中のプランで利用可能な機能を確認したうえで、Data Hubのデータ品質機能を使って表記ゆれや重複データを整えるだけでも、レポートの食い違いを減らす大きな第一歩になります。
2. Data Hubと標準レポート機能で小さく検証する
すべての外部ツールのデータを統合するには、予算確保や社内稟議に時間がかかるものです。まずはHubSpotが標準連携している広告管理画面(Google、Meta、LinkedInなど)を接続し、Marketing HubやSales Hubの行動履歴と「取引(商談)データ」を掛け合わせて分析する方法が現実的です。 プランに応じてカスタムレポートやデータセット機能を活用すれば、HubSpot単体でも継続率や簡易的なCLVに近い指標を算出でき、財務部門や経営陣と議論するための土台を作ることができます。
3. 分析結果を「リスト(セグメント)」にして施策へ戻す
日本の現場でも、時間をかけて作成した分析レポートが「会議での報告」だけで終わってしまうケースは少なくありません。セッションで実演された「分析して終わりにせず、セグメント化してHubSpotへ戻す」というアプローチは、企業規模を問わず見習うべきポイントです。 HubSpot内のレポートで分析する場合であっても、離脱しそうな層や反応の良い層を見つけたら、すぐにリスト(セグメント)機能でグループ化し、マーケティングEメールの自動配信や営業担当者へのタスク通知へ直結させる仕組みを作っておくことが重要です。
---
よくある質問(FAQ)
Q1. なぜアプリ同士を直接つながずに、1か所に集めるのですか?
Alexander氏が指摘した通り、自前でデータ連携パイプラインを組むと、ツールを1つ追加するだけでも数週間の開発作業が発生します。また、アプリ同士を直接つなぐ構成(Point-to-Point)では、連携がスパゲッティのように複雑化し、保守が困難になるためです。まずは自社でHubSpotを中心にどのツールとデータを連携しているかを書き出し、接続状況を棚卸しすることをお勧めします。
Q2. データを統合したら、最初にどの分析から始めるべきですか?
セッションでは「顧客生涯価値(CLV)」からの着手が推奨されました。顧客獲得単価(CPA)の引き上げを財務チームに相談する際も、シンプルなCLVのモデルがあれば説得力が増すためです。これを実践するには、まず営業部門でHubSpotの「取引データ」が正確に入力されているかを確認し、継続や更新の金額まで追跡できる状態を作ることが先決です。
Q3. AIの活用とデータの統合はどう関係しますか?
各部門が個別にAIエージェントを立ち上げると、各システムへのアクセスやデータ処理が重複し、コスト面で非効率になります。データを1か所に集約しておけば、1つのAIチャット画面から別チャネルのデータまで横断して参照・分析が可能になります。HubSpotのAI「Breeze」などを活用する際も、元となる顧客データが重複なく整っているかどうかが、AIの回答精度や実用性に直結します。
Q4. HubSpotへデータを書き戻すのにエンジニアは必要ですか?
セッションの実演では、データの取り込みからウェアハウスでの分析、離脱層のセグメント化、そしてHubSpotへの定期同期まで、すべてノーコード(コードを書かない画面操作)で進められる様子が紹介されました。なお、HubSpotのData Hubの同期機能などを利用する際もエンジニアは不要ですが、契約プランで利用できるかを確認したうえで、同期の頻度や「どちらのデータを正とするか(上書きルール)」を事前に決めておくと安心です。
まとめ
本セッションでは、マーケティングの成果を最大化するためには、キャンペーンの工夫よりも先に「散らばったデータを1か所に集め、数値の定義をそろえること」が不可欠であると示されました。データを一元化すれば、CLVの分析や効率的なAI活用に手が届き、抽出したセグメントをHubSpotへ書き戻して即座にアクションへ移せます。まずは自社のツールの接続状況と、HubSpot内のデータ定義を見直すところから始めてみてはいかがでしょうか。
株式会社100では、Data Hubを活用したデータ統合やプロパティの設計、レポート環境の構築を支援しています。「社内のデータがバラバラで集計に時間がかかっている」「HubSpotで正しいROIを可視化したい」とお考えの方は、ぜひお気軽にご相談ください。
中野太夢
2016年にSNSマーケティング支援会社へ新卒入社し、大手グローバル企業のSNSアカウント運用支援およびチームリーダーを担当。2020年にCRM/MA導入コンサルティング会社へ転籍し、Salesforce・Account Engagement(旧Pardot)を用いたBtoB企業の活用支援に従事。その後、飲食店舗の店長として現場運営に携わり、売上・原価・集客の改善に取り組んだ。現在は株式会社100 ソリューション事業部BizDevとして海外SaaSの日本展開を担い、日本語の営業資料・Webサイトの整備、問い合わせ獲得、社内メンバーへの提案浸透までを一気通貫で進めている。趣味はサッカー、カメラ、料理、キャンプ。
この記事をシェアする


https://hubspot.100inc.co.jp/unbound-2026-marketing-data-silos
コピーWe are HubSpot LOVERS
ビジネスの成長プラットフォームとしての魅力はもちろん、
HubSpotのインバウンドマーケティングという考え方、
顧客に対する心の寄せ方、ゆるぎなく、そしてやわらかい哲学。
そのすべてに惹かれて、HubSpotのパートナー、
エキスパートとして取り組んでいます。
HubSpotのこと、マーケティング設計・運用、
組織の構築など、どんなことでもお問い合わせください。